Docs
Il manuale, in breve.
Tutto ciò che serve per far girare MAFDET e capire cosa ti mostra. Il README su GitHub è la versione lunga e resta il riferimento.
Avvio rapido
Windows, con un doppio clic. Scarica MAFDET (su GitHub, Code → Download ZIP, e decomprimilo; oppure git clone) e fai doppio clic su start_mafdet.bat. La prima volta crea un ambiente Python in .venv e installa MAFDET, circa un minuto; serve Python 3.10 o successivo. Da lì in poi, un doppio clic apre MAFDET in meno di un secondo.
macOS, con un doppio clic. Lo stesso, con start_mafdet.command. Se il Finder dice che non può verificare il file, clic destro, Apri, poi di nuovo Apri; solo la prima volta.
Da PyPI. Su macOS con il Python di Homebrew, e sulle Ubuntu e Debian recenti, pip install fuori da un ambiente virtuale si ferma con externally-managed-environment: usa pipx, che dà a MAFDET un ambiente tutto suo.
$ brew install pipx        # Ubuntu/Debian: sudo apt install pipx · Windows: py -m pip install --user pipx
$ pipx ensurepath          # poi apri un nuovo terminale
$ pipx install mafdet
$ mafdet
Su Windows con il Python di python.org, pip install mafdet funziona così com'è. Per aggiornare: pipx upgrade mafdet (oppure pip install -U mafdet).
Dal sorgente, anche per le misurazioni in research/:
$ git clone https://github.com/TheLastOxygen/mafdet.git
$ cd mafdet
$ python -m venv .venv          # Windows: py -3.12 -m venv .venv
$ source .venv/bin/activate     # Windows: .venv\Scripts\Activate.ps1
$ pip install -e .
$ mafdet
In entrambi i casi, niente PyTorch e niente download manuali: MAFDET chiede se aprire la finestra o l'app da terminale, e il primo avvio ti guida per il resto. Guarda la tua macchina, installa la build giusta di llama.cpp (CUDA per una scheda NVIDIA, Vulkan per una AMD Radeon, Metal su un Mac Apple Silicon, CPU altrimenti) e scarica il modello che gira meglio sul tuo hardware.
L'app
La stessa app in due forme, sullo stesso motore:
| Comando | Cos'è |
|---|---|
mafdet gui | La finestra: chat, modelli, hardware e impostazioni, in inglese, italiano, francese o tedesco. |
mafdet tui | L'app da terminale: le stesse viste nel terminale, tastiera prima di tutto (da F1 a F4), su uno schermo al fosforo ambra con una sequenza di avvio. In Impostazioni, Effetti cinematografici spegne le animazioni. |
mafdet models | Il catalogo dei modelli per questa macchina (--family, --download, anche --download repository:file.gguf da Hugging Face). |
mafdet doctor | Controlla GPU, memoria, llama.cpp e i modelli; --install installa llama.cpp (--build 12, 13, vulkan o cpu per scegliere la build). |
mafdet da solo apre il launcher, che può ricordare la tua scelta (mafdet --ask lo mostra di nuovo).
Chat
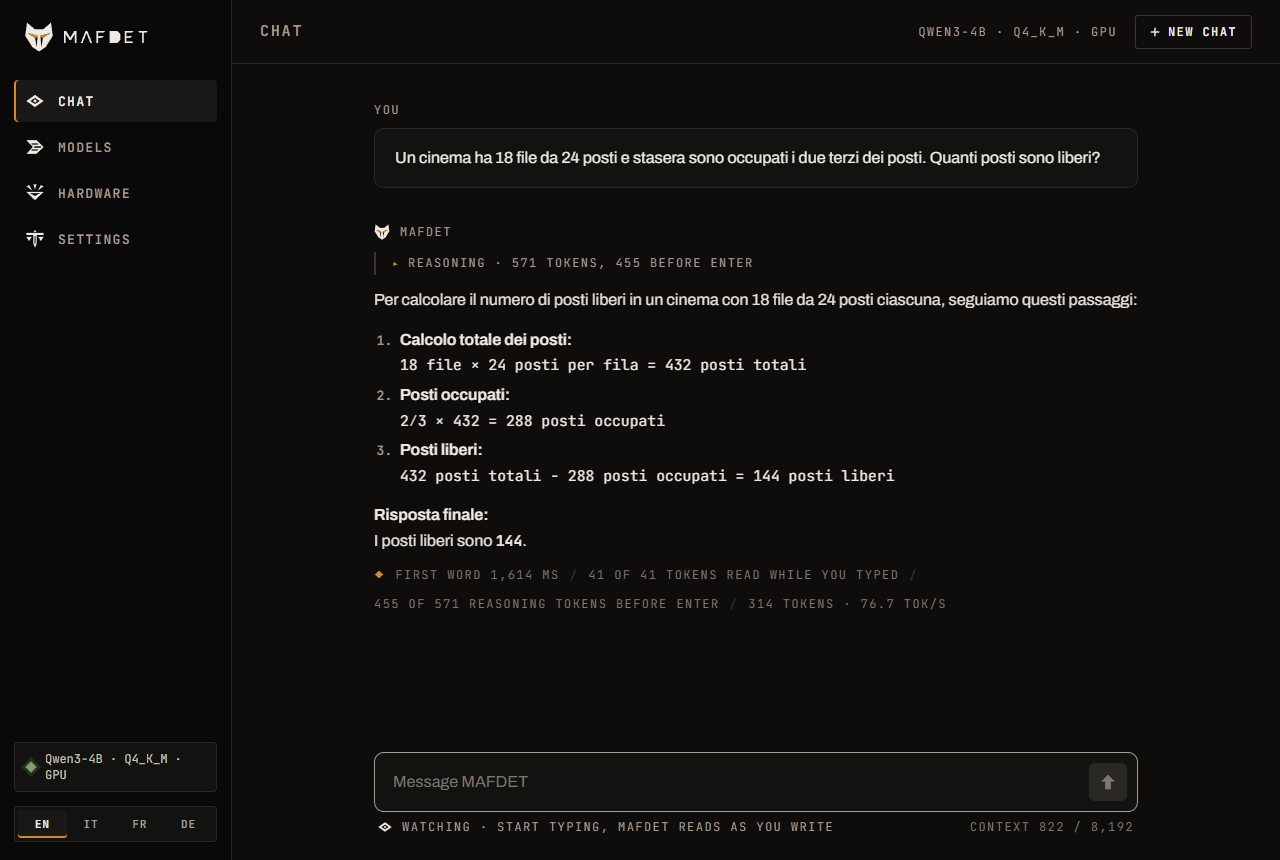
Mentre scrivi, una riga di stato sotto il messaggio mostra cosa ne sta facendo il modello: quanto ne ha letto, e quanti token di ragionamento ha scritto in anticipo (il campo si illumina di ambra mentre pensa). A Invio resta da calcolare solo la coda. Il ragionamento è mostrato ripiegato sopra la risposta, e ogni risposta finisce con i suoi numeri: prima parola dopo Invio, token letti mentre scrivevi, ragionamento fatto prima di Invio, velocità.
Modelli
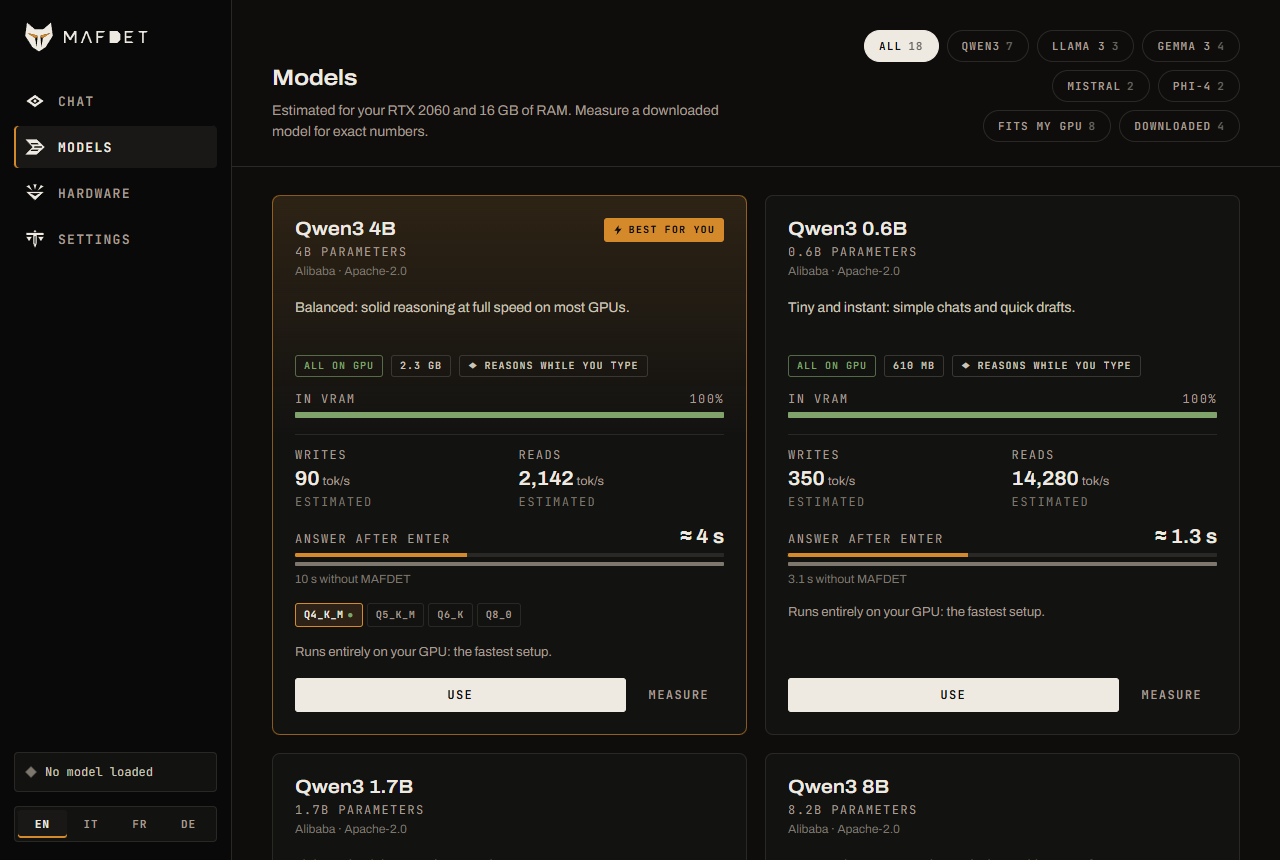
Cinque famiglie: Qwen3, Llama 3, Gemma 3, Mistral e Phi-4, da 0.6B a 32B parametri, ciascuna in più quantizzazioni. Con ogni modello, MAFDET legge il tuo messaggio mentre scrivi e, a una pausa, scrive la risposta in anticipo; Qwen3 inoltre ragiona in anticipo, l'unica famiglia di cui è stata misurata la cornice di ragionamento.
Ogni modello del catalogo arriva con ciò che fa sulla tua macchina, prima che tu lo scarichi: se sta nella VRAM o gira in parte sulla CPU, quanto veloce scrive e legge, e per Qwen3 quanto ci mette la risposta dopo Invio con e senza MAFDET. La stima viene dal tuo hardware (banda di GPU e RAM, VRAM, la divisione dei layer tra GPU e CPU fatta da llama.cpp) ed è entro il 12% dalle velocità misurate sul PC di riferimento e su un M2 Pro. Una volta scaricato un modello, Misura lo mette alla prova in mezzo minuto e i numeri reali sostituiscono la stima. Il modello che gira meglio qui è segnato Il migliore per te, e ogni famiglia ha la sua scelta migliore.
I tuoi modelli
Funziona anche qualsiasi GGUF, oltre il catalogo:
- Cerca su Hugging Face (vista Modelli) trova i repository GGUF, i più scaricati per primi, ed elenca i loro file con la stessa stima per la tua macchina; una quantizzazione è suggerita (Q4_K_M quando c'è). Il download riprende da dove si era fermato, tutte le parti di un modello diviso insieme, in
~/.mafdet/models/hf/<owner>/<repo>/. I modelli gated (Llama, Gemma) richiedono di accettare la loro licenza su huggingface.co ehf auth loginsulla macchina. - Un file scaricato a mano: mettilo in
~/.mafdet/models(in qualsiasi sottocartella), oppure scegli un file in qualsiasi punto del disco con Aggiungi un file GGUF (resta dov'è).
Compaiono sotto I tuoi modelli, con i numeri letti dall'intestazione del file e Misura come per il catalogo. Il tokenizer e il template di chat sono quelli del GGUF, letti tramite llama-server. Un Qwen3 con thinking mode ragiona in anticipo mentre scrivi; qualsiasi altro modello legge mentre scrivi e scrive la risposta in anticipo alle pause. L'architettura deve essere tra quelle supportate dal llama.cpp installato.
Pensare in anticipo
Nell'app è attivo per impostazione predefinita con Qwen3 (Impostazioni, Ragiona mentre scrivo); dalla riga di comando è mafdet strike. Il modello gira in thinking mode, quindi prima di rispondere ragiona in un blocco nascosto. Quel ragionamento è di solito l'attesa più lunga, e MAFDET ne sposta il più possibile prima di Invio:
- Mentre scrivi, il modello ragiona a brevi tratti di 32 token, sul messaggio così com'è in quel momento, su parole intere.
- Quando il testo cambia, il ragionamento non viene buttato. Resta nel prompt come appunti dopo la nuova versione del messaggio, il che costa solo un prefill, e una nuova riga degli appunti nomina le parole appena scritte, così il modello continua a raccogliere materiale su di esse invece di ricominciare da capo.
- A Invio, un'ultima frase dice al modello che il messaggio è completo. Finisce di ragionare da dove era arrivato e risponde.
Gli appunti sono una lista di materiale per la risposta, avviata da una cornice: per ogni termine chiave, nome o numero già scritto, una riga con cos'è e i fatti che il modello sa a riguardo, o un risultato parziale. La cornice conta: senza, il modello spendeva gli appunti a notare che il messaggio non era finito. Se ti fermi e mandi il messaggio senza cambiarlo, MAFDET scrive in anticipo anche la risposta stessa; quella parte è esatta e vale per il testo esatto per cui è stata scritta.
| Opzione | Cosa fa |
|---|---|
--no-think | Nessun ragionamento: risponde subito, e scrive in anticipo solo la risposta esatta. |
--think-ahead N | Ragionamento più lungo conservato tra una modifica e l'altra (predefinito 1024 token). |
--ahead N | Token di risposta scritti in anticipo quando il testo non cambia (predefinito 512). |
--branches N | Sperimentale: il modello indovina anche come finirai il messaggio e, in uno slot tutto suo, ragiona sull'ipotesi. 1 è l'impostazione misurata. |
--recycle | Riusa le risposte scritte per le versioni precedenti del messaggio come bozze n-gram per lo speculative decoding (+4% di velocità di decode misurata con digitazione naturale, +20% sul codice). |
--draft repo:file | Un modello piccolo della stessa famiglia abbozza i token per lo speculative decoding (nessun guadagno misurato sulla RTX 2060). |
mafdet watch e mafdet strike aprono la finestra con il modello e le opzioni dati sulla riga di comando (--gguf repo:file), al posto delle impostazioni dell'app. demo_live.py (start_demo.bat) è la vista passo per passo per il debug: token, cache, hold-back e tempi, dal vivo nel terminale (--auto scrive un esempio da solo).
Comandi
| Comando | Cosa fa | |
|---|---|---|
mafdet | il launcher | Finestra o terminale; ricorda la tua scelta. |
mafdet gui | la finestra | Chat, modelli, hardware e impostazioni. |
mafdet tui | l'app da terminale | Le stesse viste, tastiera prima di tutto. |
mafdet models | il catalogo | I modelli per questa macchina; --download. |
mafdet doctor | il risveglio | Controlla GPU, memoria, llama.cpp e i modelli; --install. |
mafdet watch | la veglia | La finestra di chat con un modello dalla riga di comando. |
mafdet strike | il colpo | Ragionamento anticipato mentre scrivi, con le opzioni qui sopra. |
mafdet hunt | la caccia | Simula persone che scrivono e misura l'attesa dopo l'invio. |
mafdet race | la corsa | Misura prefill e decode sulla tua macchina. |
mafdet judge | il giudizio | Confronta i risultati con un calcolo da zero: deve finire con 0 errori. |
mafdet awaken | il risveglio | Controlla PyTorch e la GPU, per il backend PyTorch. |
mafdet --help è la guida completa, mafdet <comando> --help le opzioni di un comando.
Misura e verifica
Le misurazioni girano su llama.cpp con --backend llama (PyTorch non serve), oppure su PyTorch/transformers con il predefinito --backend hf (pip install -e ".[research]" dopo aver installato PyTorch dall'indice CUDA). Aggiungi --device cpu a qualsiasi comando per misurare il caso senza GPU. I risultati sono salvati come file CSV in results/ (si cambia con --out).
mafdet hunt riproduce tre scenari di digitazione (--scenario):
- clean: un messaggio scritto dall'inizio alla fine
- messy: errori corretti con backspace, una parola cancellata e riscritta, un inserimento nel mezzo, poca punteggiatura
- paste: un documento lungo incollato, seguito da una domanda scritta a mano. È qui che il guadagno è maggiore.
La digitazione non è riprodotta in tempo reale. Ogni prefill gira davvero sul modello, e la sua durata misurata viene collocata sulla linea temporale della digitazione. Se il modello resta indietro rispetto a chi scrive, il ritardo si accumula e si somma all'attesa finale, proprio come in un sistema reale.
Hardware e impostazioni
La vista Hardware mostra GPU, CPU, memoria e il runtime di llama.cpp, con un pulsante per installarlo o reinstallarlo. Le Impostazioni conservano le opzioni della chat da un avvio all'altro, in ~/.mafdet (o $MAFDET_HOME): Ragiona mentre scrivo, la risposta scritta in anticipo, il ragionamento conservato tra una modifica e l'altra, e le opzioni sperimentali.
mafdet doctor dice cosa ha trovato. Una issue con il suo output e i file server*.log accanto a llama-server (in ~/.mafdet/llama.cpp) è la segnalazione più utile.