Qwen3-4B
RTX 2060 · 6 GB · 24 problemi
3.8×più veloce
Senza ragionamento anticipato12.2 s
◆ Con MAFDET3.2 s
24/24 in entrambi i casi. Sta nella VRAM, 83 tok/s. Più veloce in 24 problemi su 24. Ragionamento rimasto dopo Invio: 944 → 244 token.
IA locale · legge e pensa mentre scrivi
Le app di chat lasciano la GPU ferma mentre scrivi. MAFDET usa quel tempo: legge il messaggio mentre lo digiti e comincia a ragionare prima che tu prema Invio. Su Qwen3-4B l'attesa dopo Invio passa da 12.2 s a 3.2 s, con le stesse risposte. Tutto in locale, su llama.cpp.
pipx install mafdetWindows · macOS su Apple Silicon · Linux non testato · NVIDIA CUDA, AMD Vulkan, Apple Metal o CPU
Tutto nuovo per te? Leggi la versione in parole semplici →
Ferma mentre scrivi. Dopo Invio: legge il messaggio, poi ragiona da zero.
Una simulazione illustrativa nel tuo browser: qui non gira nessun modello. Tempi in scala dal benchmark di Qwen3-4B su una RTX 2060 (24 problemi scritti in tempo reale, attesa media dopo Invio 12.2 s → 3.2 s). Riproduzione a velocità 3×.
Misurato, non promesso
Problemi con una risposta numerica nota, scritti in tempo reale a 5-8 caratteri al secondo, Invio subito dopo l'ultimo carattere. L'attesa è per la prima parola della risposta. Ogni esecuzione è nel repository.
RTX 2060 · 6 GB · 24 problemi
3.8×più veloce
24/24 in entrambi i casi. Sta nella VRAM, 83 tok/s. Più veloce in 24 problemi su 24. Ragionamento rimasto dopo Invio: 944 → 244 token.
RTX 2060 · 6 GB · 6 problemi
2.3×più veloce
6/6 in entrambi i casi. Più grande della VRAM: 38% sulla GPU, circa 5 tok/s. Sei problemi danno l'ordine di grandezza, non una cifra precisa.
MacBook Pro M2 Pro · 16 GB · 24 problemi
3.2×più veloce
24/24 in entrambi i casi. Metal, 54 tok/s. Più veloce in 24 problemi su 24. Ragionamento rimasto dopo Invio: 966 → 248 token.
MacBook Pro M2 Pro · 16 GB · 6 problemi
2.7×più veloce
6/6 in entrambi i casi. L'intero 14B sta nella memoria unificata e scrive a 18 tok/s.
Condizioni
Qwen3 Q4_K_M in thinking mode su llama.cpp. Attesa media dopo Invio; la RTX 2060 ha 6 GB di VRAM, il Mac 16 GB di memoria unificata. Due esecuzioni degli stessi 24 problemi differiscono fino a un secondo: sono ordini di grandezza, con i dati e gli script per ripeterli.
Leggi la ricerca →Come funziona
Un LLM legge il prompt in una fase veloce e parallela (prefill) e poi scrive un token alla volta (decode). Un modello di ragionamento pensa per centinaia di token prima della prima parola. MAFDET sposta entrambe le fasi prima di Invio.
A ogni pausa MAFDET tokenizza il testo, tiene la KV cache allineata a esso e trattiene gli ultimi token: una parola che stai ancora scrivendo può cambiare il modo in cui il testo viene suddiviso.
Il prefill viene fatto mentre scrivi. Con Qwen3 il modello ragiona anche a brevi tratti sul messaggio così com'è. Quando modifichi il testo, quel ragionamento resta nel prompt come appunti e il modello prosegue da lì.
Vengono letti solo gli ultimi token, il modello finisce di ragionare da dove era arrivato e risponde. Su Qwen3-4B circa due terzi del ragionamento sono fatti prima di Invio.
La KV cache, allineata al tuo testo
Backspace, modifiche nel mezzo, blocchi incollati: il controllo del prefisso comune taglia la cache a ciò che vale ancora e fa il prefill solo di ciò che è nuovo. La lettura anticipata è esatta; il risultato è quello che dà un calcolo da zero.
Lettura anticipata · esatta
Euristiche come hold-back e debounce influenzano solo quanto lavoro va sprecato, mai il risultato. Verificato da mafdet judge contro un calcolo da zero: 0 errori.
Pensiero anticipato · misurato
Il modello ragiona su versioni del messaggio non ancora definitive, quindi la risposta può differire da quella a freddo. Per questo è misurato su risposte verificabili: 24/24 da entrambe le parti, sulla RTX 2060 e sull'M2 Pro.
Cosa ottieni
Niente PyTorch, niente download manuali. MAFDET guarda la tua macchina, installa la build giusta di llama.cpp e sceglie il modello che ci gira meglio. Poi comincia a lavorare prima di te.
Il prefill è fatto prima di Invio, a ogni pausa. Esatto, qualunque cosa tu faccia al testo: backspace, modifiche, documenti incollati.
Con Qwen3 il modello ragiona a brevi tratti sul messaggio così com'è, e conserva i suoi appunti quando lo cambi. Due terzi del ragionamento fatti prima di Invio sul 4B.
La macchina di riferimento è una RTX 2060 con 6 GB. Apple Silicon gira con Metal, AMD Radeon con Vulkan, e tutto gira anche su una CPU.
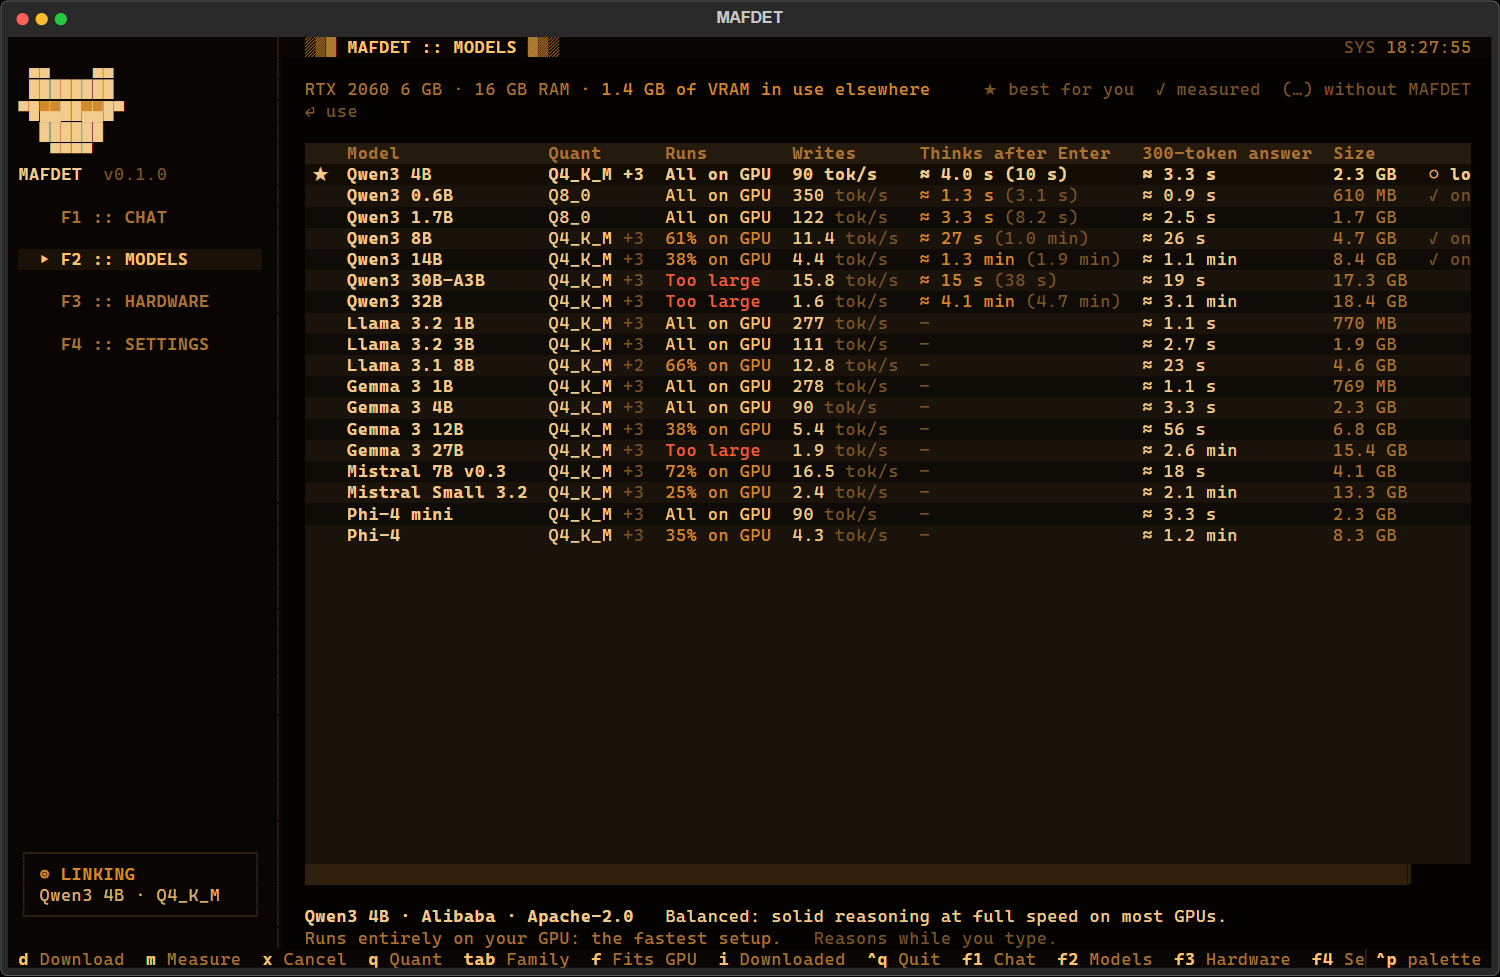
Ogni modello dice, prima del download, se sta nella VRAM, quanto veloce legge e scrive, e l'attesa dopo Invio con e senza MAFDET. Stime entro il 12% dalle velocità misurate.
Cinque famiglie nel catalogo: Qwen3, Llama 3, Gemma 3, Mistral e Phi-4. Oltre a queste, cerca su Hugging Face dall'app o aggiungi un file tuo.
Benchmark, simulazione della digitazione e controlli di correttezza sono inclusi nell'app. Misura un modello in mezzo minuto; giudica il motore contro un calcolo da zero.
L'app
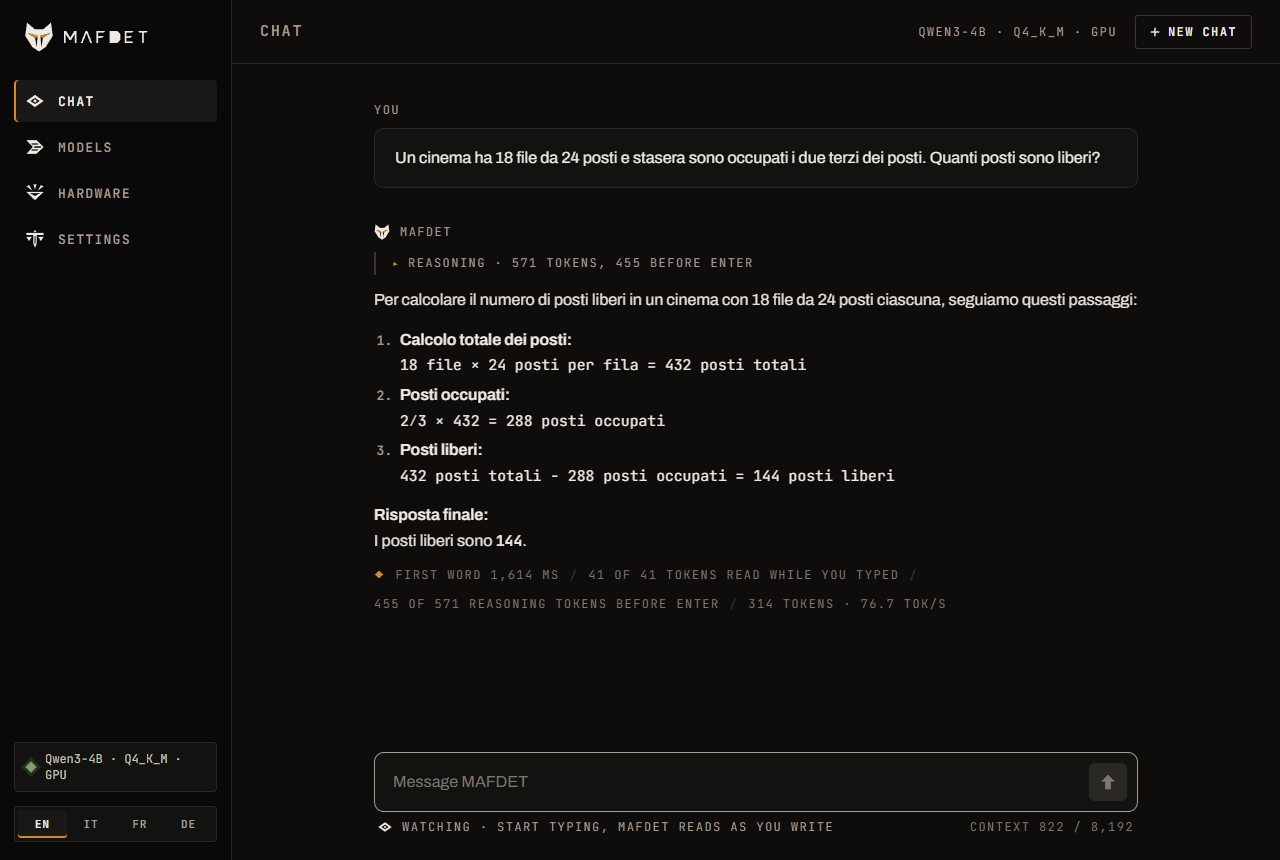
La finestra, in inglese, italiano, francese o tedesco. Oppure l'app da terminale, tastiera prima di tutto, su uno schermo al fosforo ambra con una sequenza di avvio. Stesse viste, stesso motore, stessi numeri sotto ogni risposta.
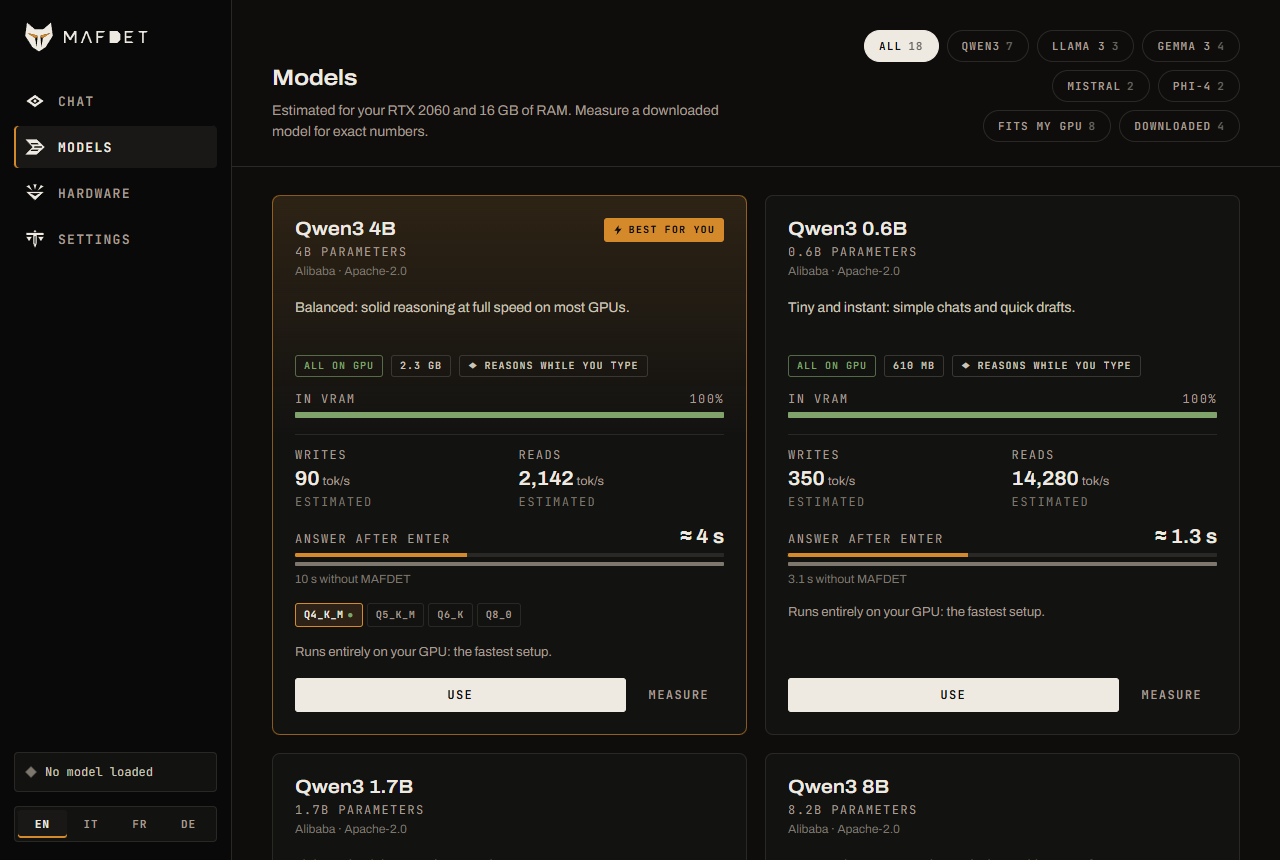
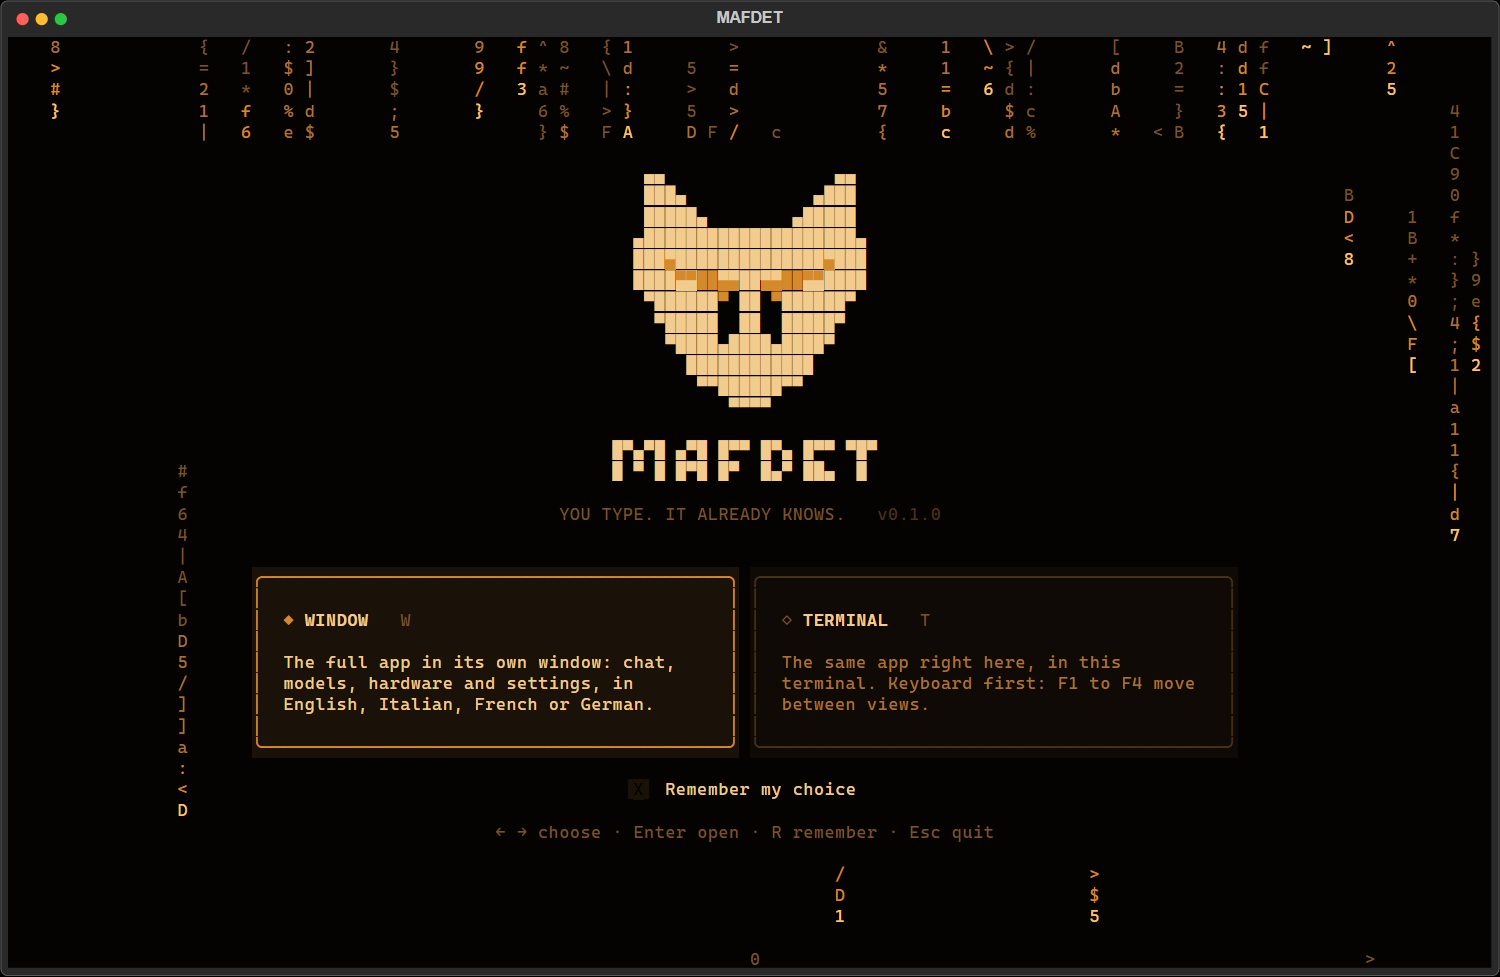
La riga di comando
Una sola CLI mafdet, nello spirito della dea da cui prende il nome. L'app e gli script di ricerca condividono lo stesso motore, quindi ciò che misuri è ciò che esegui.
$ mafdet doctor
il risveglio
Controlla GPU, memoria, llama.cpp e i modelli. --install configura llama.cpp con la build giusta.
$ mafdet watch
la veglia
La finestra di chat con un modello e le opzioni dalla riga di comando; legge in anticipo mentre scrivi.
$ mafdet strike
il colpo
Ragionamento anticipato mentre scrivi, conservato tra una modifica e l'altra, e la risposta esatta in anticipo a una pausa.
$ mafdet hunt
la caccia
Simula persone che scrivono, in modo pulito, disordinato o incollando, e misura l'attesa dopo l'invio.
$ mafdet race
la corsa
Misura prefill e decode sulla tua macchina, su llama.cpp o su PyTorch.
$ mafdet judge
il giudizio
Confronta i risultati con un calcolo da zero. Deve finire con 0 errori.
Inizia
Basta Python 3.10 o successivo. Il primo avvio guarda la tua macchina, installa llama.cpp e scarica il modello che ci gira meglio; il terminale mostra ogni download con dimensione, velocità e tempo rimanente.
Con un doppio clic
git clone).start_mafdet.bat. La prima volta crea un ambiente Python in .venv e installa MAFDET, circa un minuto. Serve Python 3.10 o successivo.Da PyPI
Con il Python di python.org, pip funziona così com'è.
$ pip install mafdet
$ mafdet
Gira su NVIDIA con CUDA (riferimento: RTX 2060, 6 GB), su AMD Radeon con Vulkan (pronto, non ancora misurato) o sulla CPU.
Con un doppio clic
git clone).start_mafdet.command. Python 3.10 o successivo: da python.org, oppure brew install python@3.12.Da PyPI, con pipx
Il Python di Homebrew rifiuta pip install fuori da un ambiente virtuale: pipx dà a MAFDET un ambiente tutto suo.
$ brew install pipx
$ pipx ensurepath        # poi apri un nuovo terminale
$ pipx install mafdet
$ mafdet
Apple Silicon (M1 o successivo) esegue i modelli sulla GPU con Metal, nella memoria unificata. Testato su un M2 Pro con 16 GB. I Mac Intel girano su CPU.
Non ancora testato
Linux ha le build di llama.cpp e i percorsi di codice pronti (CUDA, Vulkan, CPU), ma nessuno ci ha ancora eseguito MAFDET da cima a fondo. Se ci provi, una issue con l'output di mafdet doctor è la cosa più utile che puoi mandare.
Da PyPI, con pipx
Le Ubuntu e Debian recenti bloccano pip install con externally-managed-environment: usa pipx.
$ sudo apt install pipx
$ pipx ensurepath        # poi apri un nuovo terminale
$ pipx install mafdet
$ mafdet
In un terminale
Anche per le misurazioni in research/.
$ git clone https://github.com/TheLastOxygen/mafdet.git
$ cd mafdet
$ python -m venv .venv          # Windows: py -3.12 -m venv .venv
$ source .venv/bin/activate     # Windows: .venv\Scripts\Activate.ps1
$ pip install -e .
$ mafdet
Aggiornare
$ pipx upgrade mafdet # oppure: pip install -U mafdet
Gli script a doppio clic aggiornano da soli il loro ambiente dopo un git pull.
In entrambi i casi: MAFDET chiede se aprire la finestra o l'app da terminale, guarda la tua macchina, installa la build giusta di llama.cpp (CUDA, Vulkan, Metal o CPU) e scarica il modello che gira meglio. Niente PyTorch, niente download manuali.
Open source
Un prototipo di Simone Di Mauro e Simone Di Natale, il diario di ricerca pubblico, ogni benchmark nel repository con lo script che l'ha prodotto. Stelle, issue e misurazioni su altro hardware sono ciò che lo fa andare avanti. Chi sono →
Privacy
L'inferenza gira in locale, su llama.cpp. Gli unici download sono alla configurazione: llama.cpp dalle sue release su GitHub, e i modelli che scegli da Hugging Face. Dopo, non esce niente.
Roadmap
Cercasi aiuto
MAFDET gira sulle schede Radeon con la build Vulkan di llama.cpp, ma nessuno l'ha ancora misurato su una. Mezz'ora di una RX 5000 o successiva colmerebbe quel vuoto: installa, Misura Qwen3-4B, esegui research/thinking_ahead.py, apri una issue.
Domande
La lettura anticipata è esatta: la KV cache finisce identica a quella di un calcolo da zero, qualunque cosa tu abbia fatto al testo, e mafdet judge lo verifica. Il ragionamento anticipato no, perché il modello ragiona su versioni del messaggio non definitive; per questo è misurato su problemi con una risposta nota. Su Qwen3-4B: 24/24 con e senza, su entrambe le macchine.
Qwen3 in thinking mode, l'unica famiglia di cui è stata misurata la cornice di ragionamento. Ogni altro modello del catalogo, e qualsiasi GGUF che aggiungi, viene letto mentre scrivi e, a una pausa, ha la risposta scritta in anticipo; quella parte è esatta e vale per il testo esatto per cui è stata scritta.
No. L'inferenza gira in locale su llama.cpp. Gli unici download sono alla configurazione: llama.cpp dalle sue release su GitHub e i modelli da Hugging Face. I modelli gated (Llama, Gemma) richiedono di accettare la loro licenza su huggingface.co.
La macchina di riferimento è una RTX 2060 con 6 GB di VRAM. I Mac Apple Silicon eseguono i modelli sulla GPU con Metal (testato: M2 Pro, 16 GB). Le schede AMD Radeon girano con Vulkan, non ancora misurate. Tutto gira anche su una CPU; lì si consigliano 16 GB di RAM, come per i modelli più grandi della VRAM.
Circa 0.7 GB per llama.cpp con CUDA (100 MB con Vulkan, 60 MB per la CPU), più i modelli: da 0.6 GB per Qwen3-0.6B a 2.3 GB per il 4B consigliato sulle schede da 6-8 GB. Niente PyTorch.
Da Mafdet, la dea felina dell'antico Egitto detta "la corritrice", che colpiva serpenti e scorpioni prima che potessero attaccare. I sei comandi sono i suoi verbi: svegliare, vegliare, colpire, cacciare, correre, giudicare.
È un prototipo, e lo dice: Windows e macOS sono testati, Linux non ancora, Radeon non è misurata. Il motore è verificato e i risultati sono riproducibili; gli spigoli sono ancora da limare. Le issue sono benvenute.
Altro nel README, che è il manuale completo.
Gli altri modelli aspettano che tu finisca di scrivere. MAFDET parte prima.
pipx install mafdet