Docs
El manual, en corto.
Todo lo que necesitas para ejecutar MAFDET y entender lo que te muestra. El README en GitHub es la versión larga y sigue siendo la referencia.
Inicio rápido
Windows, con doble clic. Descarga MAFDET (en GitHub, Code → Download ZIP, y descomprímelo; o git clone) y haz doble clic en start_mafdet.bat. La primera vez crea un entorno de Python en .venv e instala MAFDET, alrededor de un minuto; necesita Python 3.10 o posterior. Después, un doble clic abre MAFDET en menos de un segundo.
macOS, con doble clic. Lo mismo, con start_mafdet.command. Si el Finder dice que no puede verificar el archivo, haz clic derecho, Abrir, y de nuevo Abrir; solo la primera vez.
Desde PyPI. En macOS con el Python de Homebrew, y en las versiones recientes de Ubuntu y Debian, pip install fuera de un entorno virtual se detiene con externally-managed-environment: usa pipx, que le da a MAFDET un entorno propio.
$ brew install pipx        # Ubuntu/Debian: sudo apt install pipx · Windows: py -m pip install --user pipx
$ pipx ensurepath          # luego abre una terminal nueva
$ pipx install mafdet
$ mafdet
En Windows con el Python de python.org, pip install mafdet funciona tal cual. Para actualizar: pipx upgrade mafdet (o pip install -U mafdet).
Desde el código fuente, también para las mediciones de research/:
$ git clone https://github.com/TheLastOxygen/mafdet.git
$ cd mafdet
$ python -m venv .venv          # Windows: py -3.12 -m venv .venv
$ source .venv/bin/activate     # Windows: .venv\Scripts\Activate.ps1
$ pip install -e .
$ mafdet
En cualquier caso, sin PyTorch y sin descargas manuales: MAFDET pregunta si abrir la ventana o la app de terminal, y el primer arranque te guía por el resto. Mira tu máquina, instala la build adecuada de llama.cpp (CUDA para una tarjeta NVIDIA, Vulkan para una AMD Radeon, Metal en un Mac con Apple Silicon, CPU en los demás casos) y descarga el modelo que mejor funciona en tu hardware.
La app
La misma app viene en dos formas, sobre el mismo motor:
| Comando | Qué es |
|---|---|
mafdet gui | La ventana: chat, modelos, hardware y ajustes, en inglés, italiano, francés o alemán. |
mafdet tui | La app de terminal: las mismas vistas en la terminal, pensada para el teclado (F1 a F4), en una pantalla de fósforo ámbar con secuencia de arranque. En Ajustes, Efectos cinematográficos apaga las animaciones. |
mafdet models | El catálogo de modelos para esta máquina (--family, --download, también --download repository:file.gguf desde Hugging Face). |
mafdet doctor | Comprueba la GPU, la memoria, llama.cpp y los modelos; --install instala llama.cpp (--build 12, 13, vulkan o cpu para elegir la build). |
mafdet a secas abre el lanzador, que puede recordar tu elección (mafdet --ask lo vuelve a mostrar).
Chat
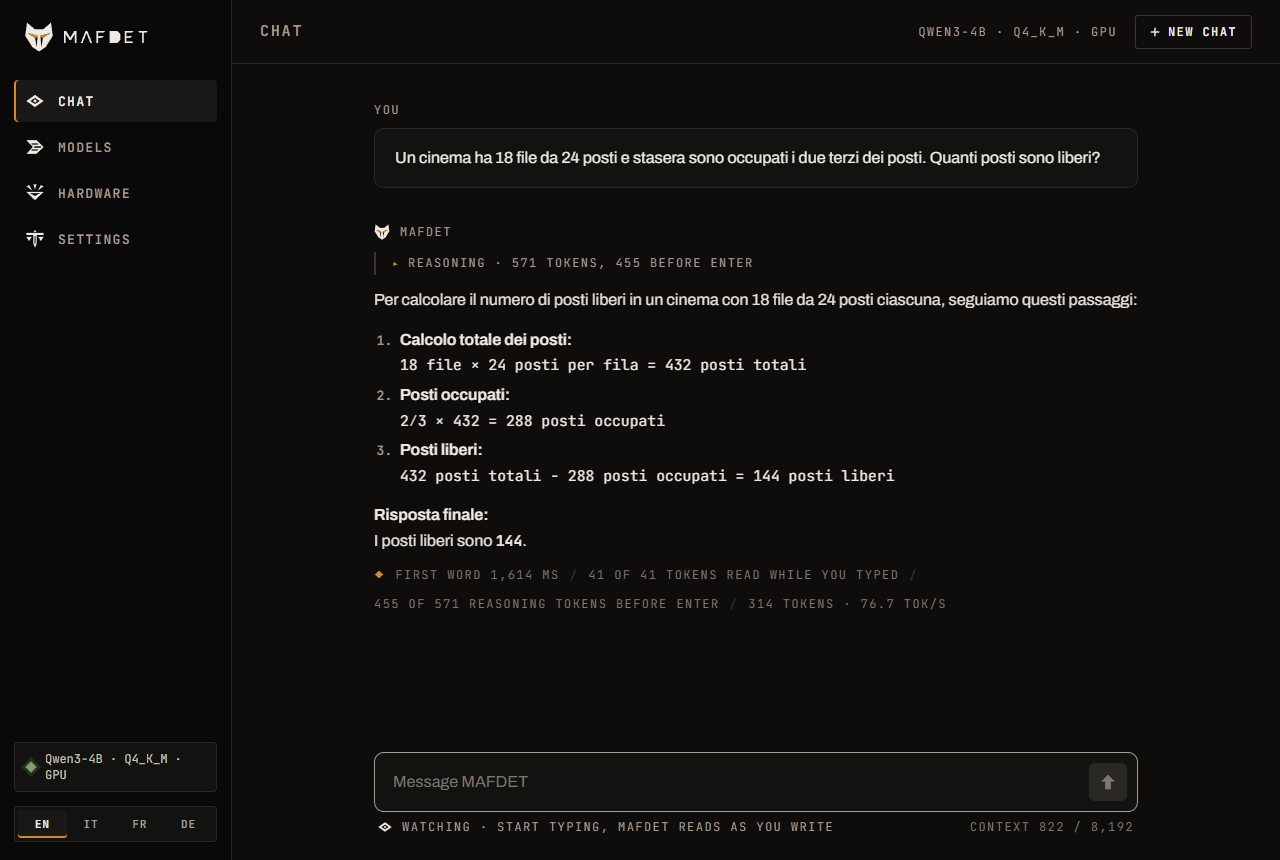
Mientras escribes, una línea de estado bajo el mensaje muestra qué está haciendo el modelo con él: cuánto ha leído y cuántos tokens de razonamiento ha escrito por adelantado (el campo brilla en ámbar mientras piensa). Al pulsar Enter solo queda por calcular la cola. El razonamiento se muestra plegado encima de la respuesta, y cada respuesta termina con sus números: primera palabra tras Enter, tokens leídos mientras escribías, razonamiento hecho antes de Enter, velocidad.
Modelos
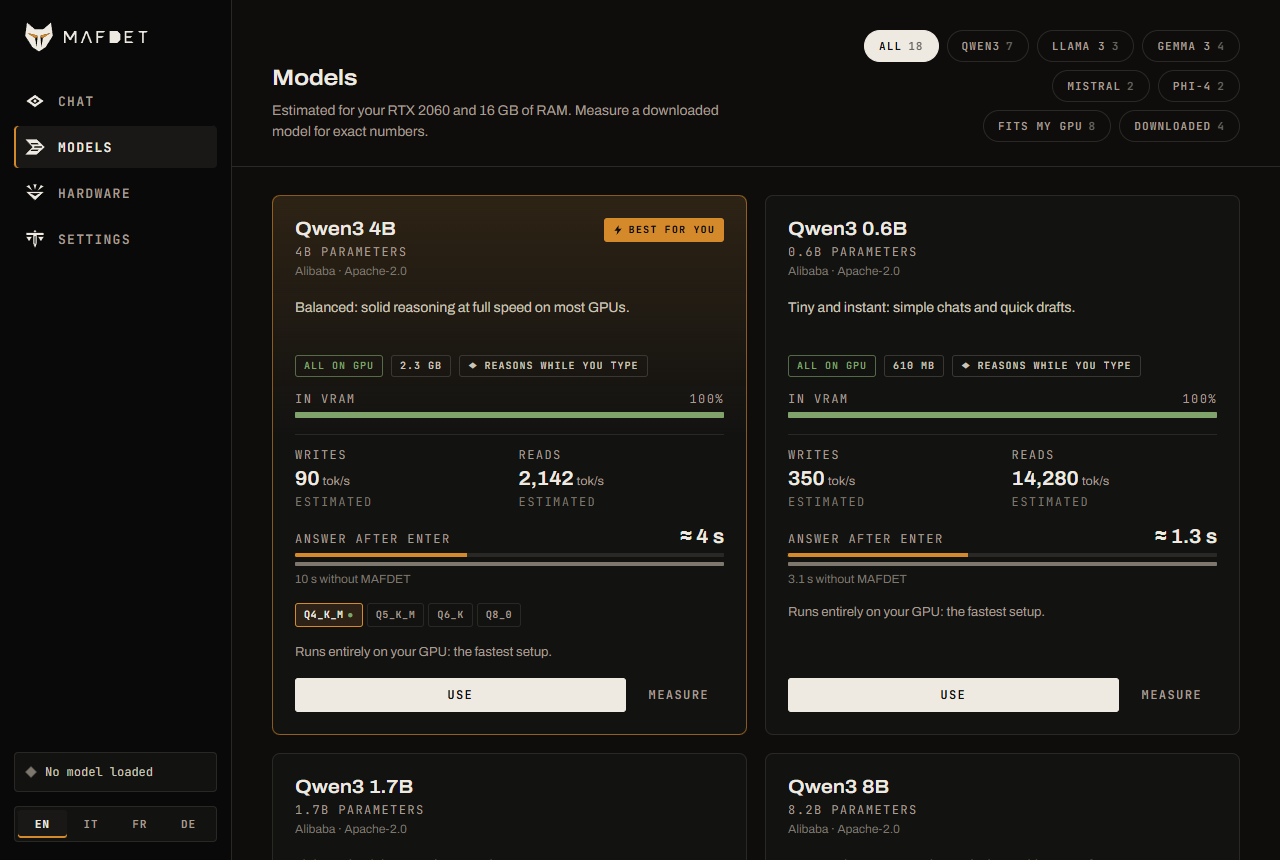
Cinco familias: Qwen3, Llama 3, Gemma 3, Mistral y Phi-4, de 0.6B a 32B parámetros, cada una en varias cuantizaciones. Con cualquier modelo, MAFDET lee tu mensaje mientras escribes y, en una pausa, escribe la respuesta por adelantado; Qwen3 además razona por adelantado, la única familia cuyo marco de razonamiento se ha medido.
Cada modelo del catálogo viene con lo que hace en tu máquina, antes de descargarlo: si cabe en la VRAM o corre en parte en la CPU, a qué velocidad escribe y lee, y para Qwen3 cuánto tarda la respuesta tras Enter con y sin MAFDET. La estimación sale de tu hardware (ancho de banda de GPU y RAM, VRAM, el reparto de capas entre GPU y CPU que hace llama.cpp) y queda dentro del 12% de las velocidades medidas en el PC de referencia y en un M2 Pro. Una vez descargado un modelo, Medir lo mide en medio minuto y los números reales sustituyen la estimación. El modelo que mejor funciona aquí se marca como El mejor para ti, y cada familia tiene su propia mejor elección.
Tus propios modelos
Cualquier GGUF funciona también, fuera del catálogo:
- Buscar en Hugging Face (vista Modelos) encuentra repositorios GGUF, los más descargados primero, y lista sus archivos con la misma estimación para tu máquina; se sugiere una cuantización (Q4_K_M cuando la hay). La descarga se reanuda donde se detuvo, todas las partes de un modelo dividido juntas, en
~/.mafdet/models/hf/<owner>/<repo>/. Los modelos con acceso restringido (Llama, Gemma) requieren aceptar su licencia en huggingface.co yhf auth loginen la máquina. - Un archivo descargado a mano: ponlo en
~/.mafdet/models(en cualquier subcarpeta), o elígelo en cualquier sitio del disco con Añadir un archivo GGUF (se queda donde está).
Aparecen bajo Tus modelos, con los números leídos de la cabecera del archivo y Medir como en el catálogo. El tokenizador y la plantilla de chat son los propios del GGUF, leídos a través de llama-server. Un Qwen3 con modo thinking razona por adelantado mientras escribes; cualquier otro modelo lee mientras escribes y escribe la respuesta por adelantado en las pausas. La arquitectura debe ser una que soporte el llama.cpp instalado.
Pensar por adelantado
En la app esto está activado por defecto para Qwen3 (Ajustes, Razonar mientras escribo); desde la línea de comandos es mafdet strike. El modelo corre en modo thinking, así que antes de responder razona en un bloque oculto. Ese razonamiento suele ser la espera más larga, y MAFDET mueve todo lo posible de él a antes de Enter:
- Mientras escribes, el modelo razona en fragmentos cortos de 32 tokens, sobre el mensaje tal como está en ese momento, sobre palabras completas.
- Cuando el texto cambia, el razonamiento no se tira. Se queda en el prompt como notas después de la nueva versión del mensaje, lo que solo cuesta un prefill, y una nueva línea de las notas nombra las palabras recién escritas, así que el modelo sigue reuniendo material sobre ellas en vez de empezar de nuevo.
- Al pulsar Enter, una última frase le dice al modelo que el mensaje está completo. Termina de razonar desde donde iba y responde.
Las notas son una lista de material para la respuesta, iniciada por un marco: por cada término clave, nombre o número ya escrito, una línea con qué es y los hechos que el modelo sabe sobre él, o un resultado parcial. El marco importa: sin uno, el modelo gastaba sus notas en señalar que el mensaje estaba incompleto. Si haces una pausa y envías el mensaje sin cambios, MAFDET también escribe por adelantado la respuesta misma; esa parte es exacta y vale para el texto exacto para el que se escribió.
| Opción | Qué hace |
|---|---|
--no-think | Sin razonamiento: responde de inmediato, y escribe por adelantado solo la respuesta exacta. |
--think-ahead N | Razonamiento máximo conservado entre ediciones (por defecto 1024 tokens). |
--ahead N | Tokens de respuesta escritos por adelantado cuando el texto no cambia (por defecto 512). |
--branches N | Experimental: el modelo también adivina cómo terminarás el mensaje y, en un slot propio, razona sobre la suposición. 1 es el ajuste medido. |
--recycle | Reutiliza las respuestas escritas para versiones anteriores del mensaje como borradores n-gram para decodificación especulativa (+4% de velocidad de decode medido con escritura natural, +20% en código). |
--draft repo:file | Un modelo pequeño de la misma familia redacta tokens para decodificación especulativa (ninguna ganancia medida en la RTX 2060). |
mafdet watch y mafdet strike abren la ventana con el modelo y las opciones dadas en la línea de comandos (--gguf repo:file), en vez de los ajustes de la app. demo_live.py (start_demo.bat) es la vista paso a paso para depurar: tokens, caché, retención y tiempos, en vivo en la terminal (--auto teclea un ejemplo por sí solo).
Comandos
| Comando | Qué hace | |
|---|---|---|
mafdet | el lanzador | Ventana o terminal; recuerda tu elección. |
mafdet gui | la ventana | Chat, modelos, hardware y ajustes. |
mafdet tui | la app de terminal | Las mismas vistas, pensadas para el teclado. |
mafdet models | el catálogo | Los modelos para esta máquina; --download. |
mafdet doctor | el despertar | Comprueba la GPU, la memoria, llama.cpp y los modelos; --install. |
mafdet watch | el acecho | La ventana de chat con un modelo desde la línea de comandos. |
mafdet strike | el golpe | Razonamiento anticipado mientras escribes, con las opciones de arriba. |
mafdet hunt | la caza | Simula a personas escribiendo y mide la espera tras el envío. |
mafdet race | la carrera | Mide prefill y decode en tu máquina. |
mafdet judge | el juicio | Comprueba los resultados contra un cálculo desde cero: debe terminar con 0 errores. |
mafdet awaken | el despertar | Comprueba PyTorch y la GPU, para el backend de PyTorch. |
mafdet --help es la guía completa, mafdet <command> --help las opciones de uno.
Medir y verificar
Las mediciones corren sobre llama.cpp con --backend llama (no hace falta PyTorch), o sobre PyTorch/transformers con el --backend hf por defecto (pip install -e ".[research]" después de instalar PyTorch desde el índice CUDA). Añade --device cpu a cualquier comando para medir el caso sin GPU. Los resultados se guardan como archivos CSV en results/ (cámbialo con --out).
mafdet hunt reproduce tres escenarios de escritura (--scenario):
- clean: un mensaje tecleado de principio a fin
- messy: erratas corregidas con retroceso, una palabra borrada y vuelta a escribir, una inserción en medio, poca puntuación
- paste: un documento largo pegado, seguido de una pregunta tecleada. Aquí es donde la ganancia es mayor.
La escritura no se reproduce en tiempo real. Cada prefill corre de verdad en el modelo, y su duración medida se coloca en la línea temporal de la escritura. Si el modelo se queda atrás respecto a quien teclea, el retraso se acumula y se suma a la espera final, igual que en un sistema real.
Hardware y ajustes
La vista Hardware muestra la GPU, la CPU, la memoria y el runtime de llama.cpp, con un botón para instalarlo o reinstalarlo. Ajustes conserva las opciones del chat de un arranque al siguiente, en ~/.mafdet (o $MAFDET_HOME): Razonar mientras escribo, la respuesta escrita por adelantado, el razonamiento conservado entre ediciones y las opciones experimentales.
mafdet doctor dice lo que ha encontrado. Un issue con su salida y los archivos server*.log junto a llama-server (en ~/.mafdet/llama.cpp) es el informe más útil.