Docs
Le manuel, en court.
Tout ce qu'il faut pour faire tourner MAFDET et comprendre ce qu'il vous montre. Le README sur GitHub est la version longue et reste la référence.
Démarrage rapide
Windows, en double-cliquant. Téléchargez MAFDET (sur GitHub, Code → Download ZIP, puis décompressez-le ; ou git clone) et double-cliquez sur start_mafdet.bat. La première fois, il crée un environnement Python dans .venv et installe MAFDET, environ une minute ; il faut Python 3.10 ou plus récent. Ensuite, un double-clic ouvre MAFDET en moins d'une seconde.
macOS, en double-cliquant. Pareil, avec start_mafdet.command. Si le Finder dit qu'il ne peut pas vérifier le fichier, clic droit dessus, Ouvrir, puis Ouvrir encore ; seulement la première fois.
Depuis PyPI. Sur macOS avec le Python de Homebrew, et sur les Ubuntu et Debian récents, pip install hors d'un environnement virtuel s'arrête avec externally-managed-environment : utilisez pipx, qui donne à MAFDET un environnement à lui.
$ brew install pipx        # Ubuntu/Debian : sudo apt install pipx · Windows : py -m pip install --user pipx
$ pipx ensurepath          # puis ouvrez un nouveau terminal
$ pipx install mafdet
$ mafdet
Sur Windows avec le Python de python.org, pip install mafdet fonctionne tel quel. Pour mettre à jour : pipx upgrade mafdet (ou pip install -U mafdet).
Depuis les sources, aussi pour les mesures dans research/ :
$ git clone https://github.com/TheLastOxygen/mafdet.git
$ cd mafdet
$ python -m venv .venv          # Windows : py -3.12 -m venv .venv
$ source .venv/bin/activate     # Windows : .venv\Scripts\Activate.ps1
$ pip install -e .
$ mafdet
Dans les deux cas, pas de PyTorch et pas de téléchargements manuels : MAFDET demande s'il faut ouvrir la fenêtre ou l'appli terminal, et le premier démarrage vous guide pour le reste. Il examine votre machine, installe la bonne build de llama.cpp (CUDA pour une carte NVIDIA, Vulkan pour une AMD Radeon, Metal sur un Mac Apple Silicon, CPU sinon) et télécharge le modèle qui tourne le mieux sur votre matériel.
L'appli
La même appli existe sous deux formes, sur le même moteur :
| Commande | Ce que c'est |
|---|---|
mafdet gui | La fenêtre : chat, modèles, matériel et réglages, en anglais, italien, français ou allemand. |
mafdet tui | L'appli terminal : les mêmes vues dans le terminal, clavier d'abord (F1 à F4), sur un écran au phosphore ambré avec une séquence de démarrage. Réglages, Effets cinématiques, coupe les animations. |
mafdet models | Le catalogue de modèles pour cette machine (--family, --download, aussi --download repository:file.gguf depuis Hugging Face). |
mafdet doctor | Vérifie le GPU, la mémoire, llama.cpp et les modèles ; --install installe llama.cpp (--build 12, 13, vulkan ou cpu pour choisir la build). |
mafdet seul ouvre le lanceur, qui peut se souvenir de votre choix (mafdet --ask le redemande).
Chat
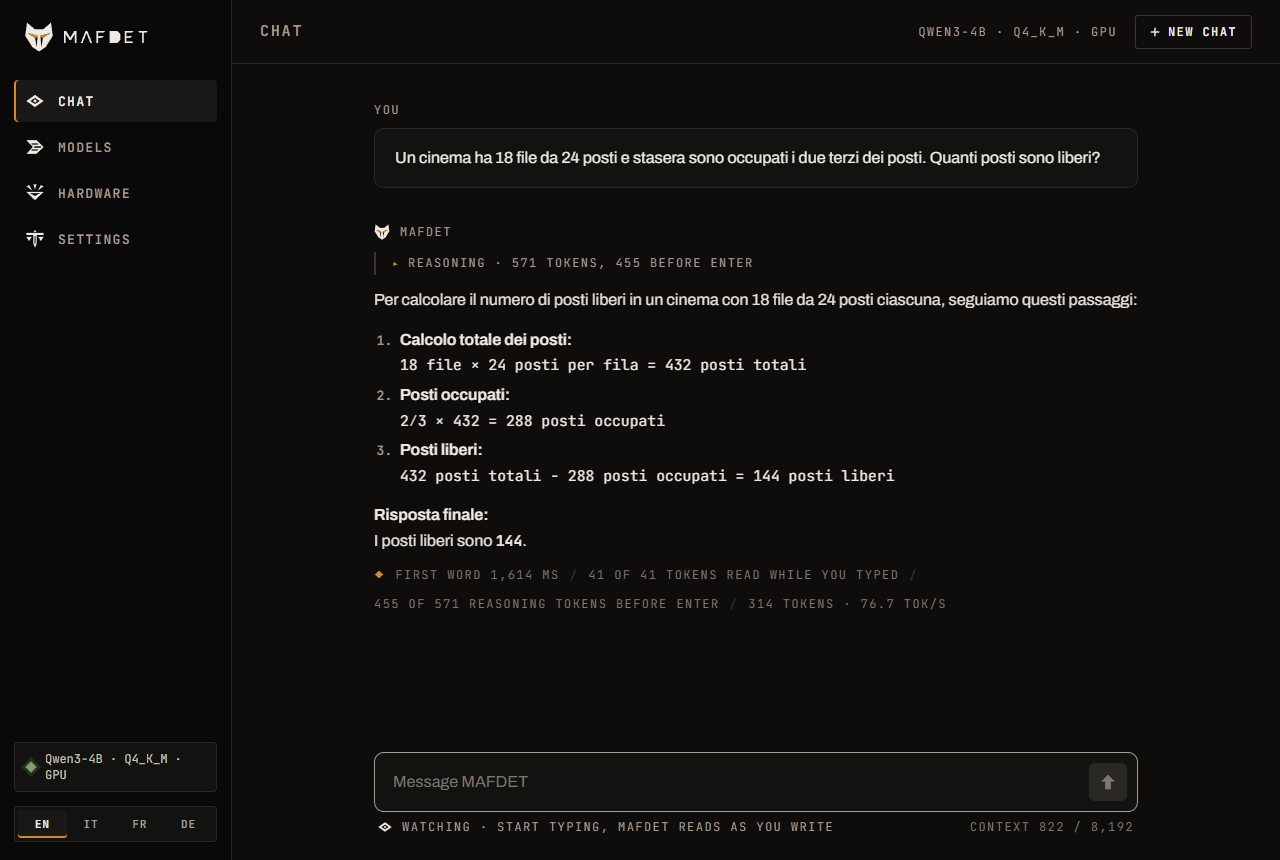
Pendant que vous tapez, une ligne d'état sous le message montre ce que le modèle en fait : combien il en a lu, et combien de tokens de raisonnement il a écrits d'avance (le champ s'allume en ambre pendant qu'il réfléchit). À Entrée, il ne reste que la fin à calculer. Le raisonnement est affiché replié au-dessus de la réponse, et chaque réponse se termine par ses chiffres : premier mot après Entrée, tokens lus pendant la frappe, raisonnement fait avant Entrée, vitesse.
Modèles
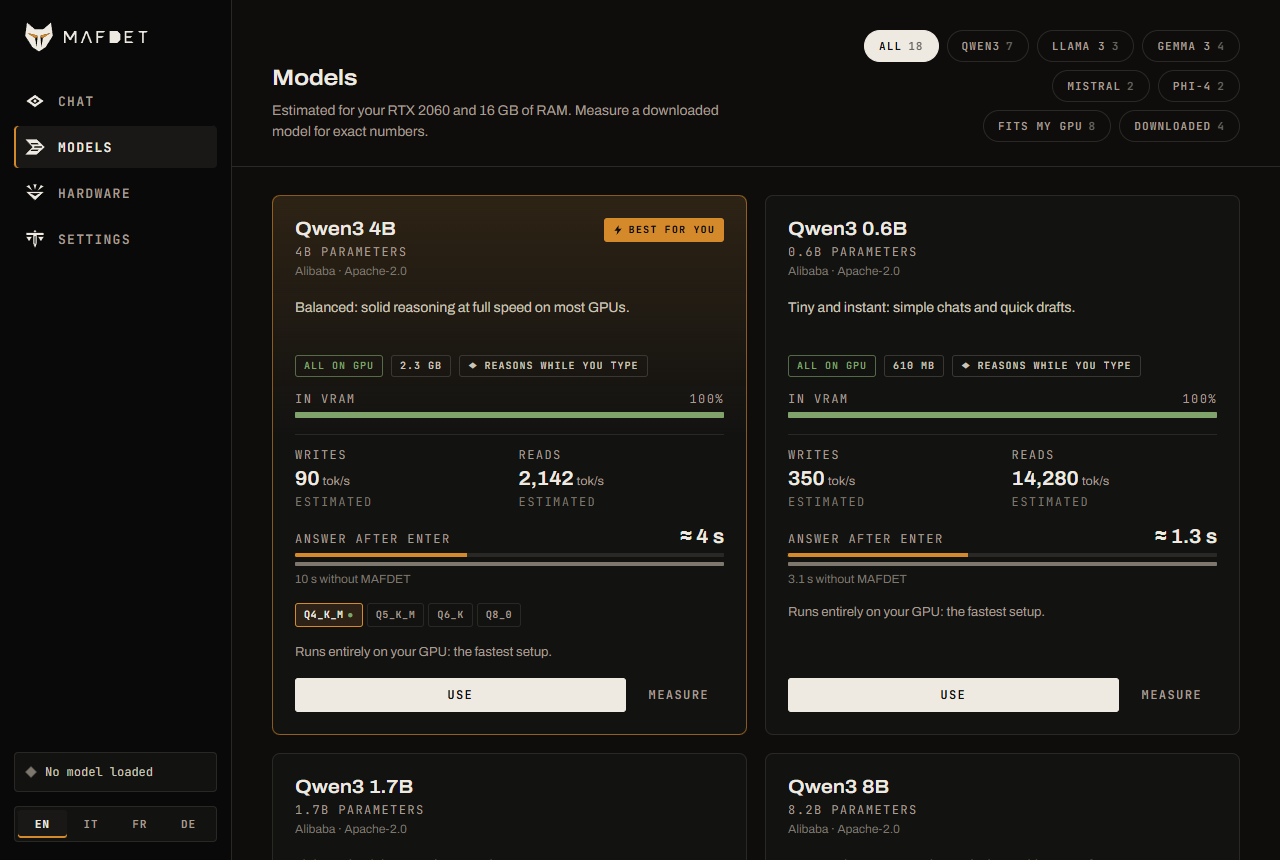
Cinq familles : Qwen3, Llama 3, Gemma 3, Mistral et Phi-4, de 0.6B à 32B paramètres, chacune en plusieurs quantizations. Avec chaque modèle, MAFDET lit votre message pendant que vous tapez et, à une pause, écrit la réponse d'avance ; Qwen3 raisonne aussi à l'avance, la seule famille dont le cadre de raisonnement a été mesuré.
Chaque modèle du catalogue vient avec ce qu'il fait sur votre machine, avant que vous ne le téléchargiez : s'il tient dans la VRAM ou tourne en partie sur le CPU, à quelle vitesse il écrit et lit, et pour Qwen3 combien de temps prend la réponse après Entrée avec et sans MAFDET. L'estimation vient de votre matériel (bande passante du GPU et de la RAM, VRAM, répartition des couches entre GPU et CPU par llama.cpp) et se situe à 12 % près des vitesses mesurées sur le PC de référence et sur un M2 Pro. Une fois un modèle téléchargé, Mesurer le benchmarke en une demi-minute et les vrais chiffres remplacent l'estimation. Le modèle qui tourne le mieux ici est marqué Le meilleur pour vous, et chaque famille a son propre meilleur choix.
Vos propres modèles
N'importe quel GGUF fonctionne aussi, au-delà du catalogue :
- Chercher sur Hugging Face (vue Modèles) trouve les dépôts GGUF, les plus téléchargés d'abord, et liste leurs fichiers avec la même estimation pour votre machine ; une quantization est suggérée (Q4_K_M quand il y en a une). Le téléchargement reprend là où il s'est arrêté, toutes les parties d'un modèle découpé ensemble, dans
~/.mafdet/models/hf/<owner>/<repo>/. Les modèles à accès restreint (Llama, Gemma) demandent d'accepter leur licence sur huggingface.co ethf auth loginsur la machine. - Un fichier téléchargé à la main : mettez-le dans
~/.mafdet/models(n'importe quel sous-dossier), ou choisissez-le n'importe où sur le disque avec Ajouter un fichier GGUF (il reste où il est).
Ils apparaissent sous Vos modèles, avec les chiffres lus dans l'en-tête du fichier et Mesurer comme pour le catalogue. Le tokenizer et le template de chat sont ceux du GGUF, lus via llama-server. Un Qwen3 avec mode thinking raisonne à l'avance pendant que vous tapez ; tout autre modèle lit pendant que vous tapez et écrit la réponse d'avance aux pauses. L'architecture doit être une de celles que le llama.cpp installé prend en charge.
Réflexion anticipée
Dans l'appli, c'est activé par défaut pour Qwen3 (Réglages, Raisonner pendant que je tape) ; en ligne de commande, c'est mafdet strike. Le modèle tourne en mode thinking : avant de répondre, il raisonne dans un bloc caché. Ce raisonnement est en général la plus longue attente, et MAFDET en déplace le plus possible avant Entrée :
- Pendant que vous tapez, le modèle raisonne par courts segments de 32 tokens, sur le message tel qu'il est à ce moment-là, sur des mots entiers.
- Quand le texte change, le raisonnement n'est pas jeté. Il reste dans le prompt sous forme de notes après la nouvelle version du message, ce qui ne coûte qu'un prefill, et une nouvelle ligne des notes nomme les mots qui viennent d'être tapés, pour que le modèle continue à rassembler du matériel sur eux au lieu de repartir de zéro.
- À Entrée, une dernière phrase dit au modèle que le message est complet. Il termine son raisonnement là où il en était et répond.
Les notes sont une liste de matériel pour la réponse, amorcée par un cadre : pour chaque terme clé, nom ou nombre déjà écrit, une ligne avec ce que c'est et les faits que le modèle connaît à son sujet, ou un résultat partiel. Le cadre compte : sans lui, le modèle passait ses notes à remarquer que le message n'était pas fini. Si vous faites une pause et envoyez le message inchangé, MAFDET écrit aussi la réponse elle-même d'avance ; cette partie est exacte et vaut pour le texte exact pour lequel elle a été écrite.
| Option | Ce qu'elle fait |
|---|---|
--no-think | Pas de raisonnement : répondre tout de suite, et n'écrire d'avance que la réponse exacte. |
--think-ahead N | Longueur maximale du raisonnement conservé d'une modification à l'autre (1024 tokens par défaut). |
--ahead N | Tokens de réponse écrits d'avance quand le texte ne change pas (512 par défaut). |
--branches N | Expérimental : le modèle devine aussi comment vous allez finir le message et, sur un slot à lui, raisonne sur cette hypothèse. 1 est le réglage mesuré. |
--recycle | Réutilise les réponses écrites pour les versions précédentes du message comme brouillons n-grammes pour le décodage spéculatif (+4 % de vitesse de decode mesurés avec une frappe naturelle, +20 % sur du code). |
--draft repo:file | Un petit modèle de la même famille rédige des brouillons de tokens pour le décodage spéculatif (aucun gain mesuré sur la RTX 2060). |
mafdet watch et mafdet strike ouvrent la fenêtre avec le modèle et les options donnés en ligne de commande (--gguf repo:file), au lieu des réglages de l'appli. demo_live.py (start_demo.bat) est la vue pas à pas pour le débogage : tokens, cache, retenue et temps, en direct dans le terminal (--auto tape un exemple tout seul).
Commandes
| Commande | Ce qu'elle fait | |
|---|---|---|
mafdet | le lanceur | Fenêtre ou terminal ; se souvient de votre choix. |
mafdet gui | la fenêtre | Chat, modèles, matériel et réglages. |
mafdet tui | l'appli terminal | Les mêmes vues, clavier d'abord. |
mafdet models | le catalogue | Les modèles pour cette machine ; --download. |
mafdet doctor | l'éveil | Vérifie le GPU, la mémoire, llama.cpp et les modèles ; --install. |
mafdet watch | l'affût | La fenêtre de chat avec un modèle depuis la ligne de commande. |
mafdet strike | la frappe | Raisonnement anticipé pendant que vous tapez, avec les options ci-dessus. |
mafdet hunt | la chasse | Simule des gens qui tapent et mesure l'attente après l'envoi. |
mafdet race | la course | Benchmarks du prefill et du decode sur votre machine. |
mafdet judge | le jugement | Vérifie les résultats contre un calcul à partir de zéro : doit se terminer avec 0 erreur. |
mafdet awaken | l'éveil | Vérifie PyTorch et le GPU, pour le backend PyTorch. |
mafdet --help est le guide complet, mafdet <command> --help les options d'une commande.
Mesurer et vérifier
Les mesures tournent sur llama.cpp avec --backend llama (pas besoin de PyTorch), ou sur PyTorch/transformers avec le --backend hf par défaut (pip install -e ".[research]" après avoir installé PyTorch depuis l'index CUDA). Ajoutez --device cpu à n'importe quelle commande pour mesurer le cas sans GPU. Les résultats sont enregistrés en fichiers CSV dans results/ (modifiable avec --out).
mafdet hunt rejoue trois scénarios de frappe (--scenario) :
- clean : un message tapé du début à la fin
- messy : des fautes corrigées au retour arrière, un mot effacé et retapé, une insertion au milieu, peu de ponctuation
- paste : un long document collé, suivi d'une question tapée. C'est là que le gain est le plus grand.
La frappe n'est pas rejouée en temps réel. Chaque prefill tourne réellement sur le modèle, et sa durée mesurée est placée sur la chronologie de la frappe. Si le modèle prend du retard sur le dactylographe, le retard s'accumule et s'ajoute à l'attente finale, comme dans un vrai système.
Matériel et réglages
La vue Matériel montre le GPU, le CPU, la mémoire et le runtime llama.cpp, avec un bouton pour l'installer ou le réinstaller. Les Réglages conservent les options de chat d'un démarrage à l'autre, dans ~/.mafdet (ou $MAFDET_HOME) : Raisonner pendant que je tape, la réponse écrite d'avance, le raisonnement conservé d'une modification à l'autre, et les options expérimentales.
mafdet doctor dit ce qu'il a trouvé. Une issue avec sa sortie et les fichiers server*.log à côté de llama-server (dans ~/.mafdet/llama.cpp) est le rapport le plus utile.