Qwen3-4B
RTX 2060 · 6 GB · 24 problèmes
3.8×plus rapide
24/24 dans les deux cas. Tient dans la VRAM, 83 tok/s. Plus rapide sur 24 problèmes sur 24. Raisonnement restant après Entrée : 944 → 244 tokens.
IA locale · lit et réfléchit pendant que vous tapez
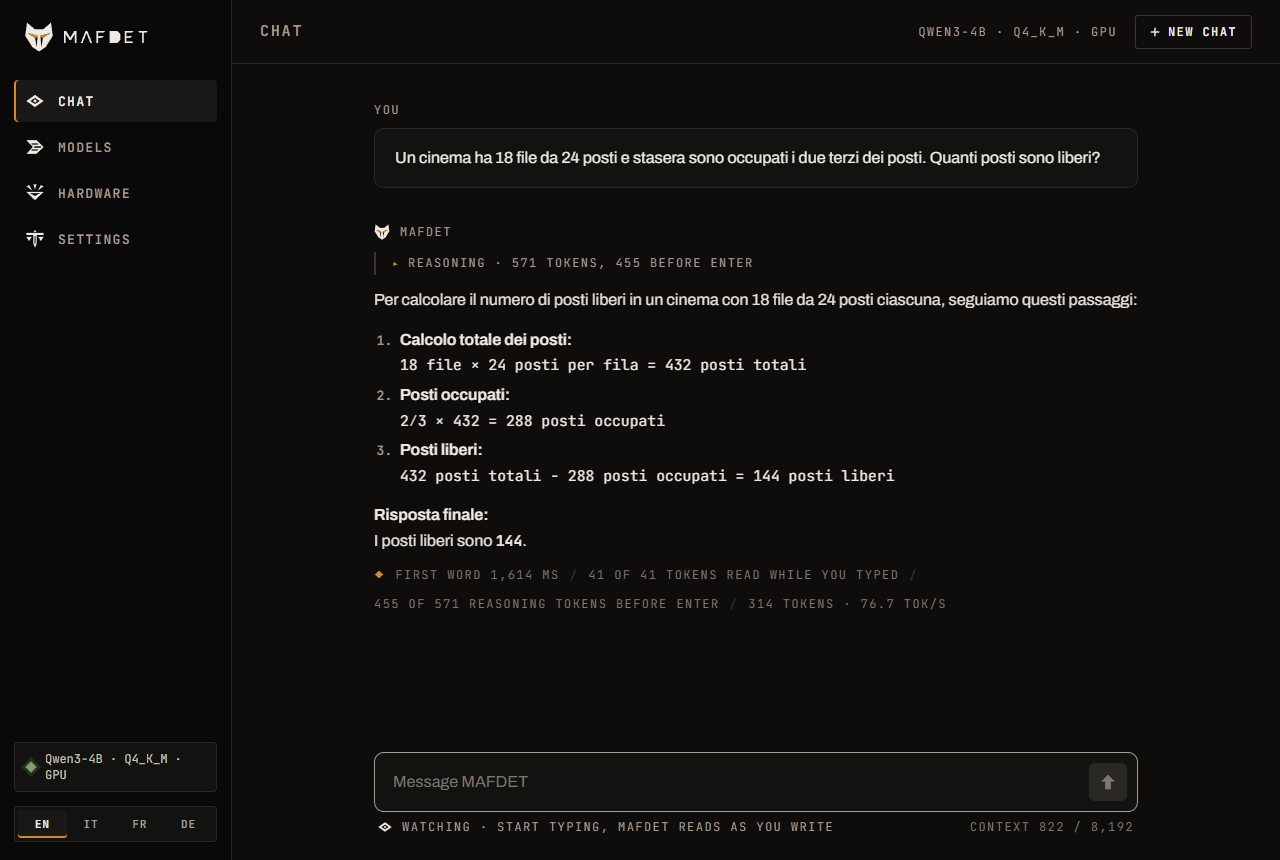
Les applis de chat laissent le GPU inactif pendant que vous écrivez. MAFDET utilise ce temps : il lit votre message pendant que vous le tapez et commence à raisonner avant que vous n'appuyiez sur Entrée. Sur Qwen3-4B, l'attente après Entrée passe de 12.2 s à 3.2 s, mêmes réponses. Entièrement en local, sur llama.cpp.
pipx install mafdetWindows · macOS sur Apple Silicon · Linux non testé · NVIDIA CUDA, AMD Vulkan, Apple Metal ou CPU
Tout cela est nouveau pour vous ? Lisez la version en clair →
Inactif pendant que vous tapez. Après Entrée : lire le message, puis raisonner à partir de zéro.
Une simulation illustrative dans votre navigateur : aucun modèle ne tourne ici. Temps mis à l'échelle à partir du benchmark Qwen3-4B sur une RTX 2060 (24 problèmes tapés en temps réel, attente moyenne après Entrée 12.2 s → 3.2 s). Lecture à vitesse 3×.
Mesuré, pas promis
Des problèmes à réponse numérique connue, tapés en temps réel à 5 à 8 caractères par seconde, Entrée juste après le dernier caractère. L'attente est celle du premier mot de la réponse. Chaque exécution est dans le dépôt.
RTX 2060 · 6 GB · 24 problèmes
3.8×plus rapide
24/24 dans les deux cas. Tient dans la VRAM, 83 tok/s. Plus rapide sur 24 problèmes sur 24. Raisonnement restant après Entrée : 944 → 244 tokens.
RTX 2060 · 6 GB · 6 problèmes
2.3×plus rapide
6/6 dans les deux cas. Plus gros que la VRAM : 38 % sur le GPU, environ 5 tok/s. Six problèmes donnent l'ordre de grandeur, pas un chiffre précis.
MacBook Pro M2 Pro · 16 GB · 24 problèmes
3.2×plus rapide
24/24 dans les deux cas. Metal, 54 tok/s. Plus rapide sur 24 problèmes sur 24. Raisonnement restant après Entrée : 966 → 248 tokens.
MacBook Pro M2 Pro · 16 GB · 6 problèmes
2.7×plus rapide
6/6 dans les deux cas. Le 14B tient en entier dans la mémoire unifiée et écrit à 18 tok/s.
Conditions
Qwen3 Q4_K_M en mode thinking sur llama.cpp. Attente moyenne après Entrée ; la RTX 2060 a 6 Go de VRAM, le Mac 16 Go de mémoire unifiée. Deux exécutions des mêmes 24 problèmes diffèrent jusqu'à une seconde : ce sont des ordres de grandeur, avec les données et les scripts pour les reproduire.
Lire la recherche →Comment ça marche
Un LLM lit un prompt dans une phase rapide et parallèle (prefill), puis écrit un token à la fois (decode). Un modèle de raisonnement réfléchit pendant des centaines de tokens avant son premier mot. MAFDET déplace les deux avant Entrée.
À chaque pause, MAFDET tokenise le texte, garde le cache KV synchronisé avec lui et retient les derniers tokens : un mot que vous êtes encore en train de taper peut changer la façon dont le texte est découpé.
Le prefill se fait pendant que vous écrivez. Avec Qwen3, le modèle raisonne aussi par courts segments sur le message tel qu'il est. Quand vous modifiez le texte, ce raisonnement reste dans le prompt sous forme de notes et le modèle continue à partir de là.
Seuls les derniers tokens sont lus, le modèle termine son raisonnement là où il en était, et répond. Sur Qwen3-4B, environ deux tiers du raisonnement sont faits avant Entrée.
Le cache KV, synchronisé avec votre texte
Retours arrière, modifications au milieu, blocs collés : la vérification du préfixe commun réduit le cache à ce qui tient encore et ne préremplit que ce qui est nouveau. La lecture anticipée est exacte ; le résultat est celui d'un calcul à partir de zéro.
Lecture anticipée · exacte
Les heuristiques comme la retenue des derniers tokens et le debounce n'affectent que la quantité de travail gaspillé, jamais le résultat. Vérifié par mafdet judge contre un calcul à partir de zéro : 0 erreur.
Réflexion anticipée · mesurée
Le modèle raisonne sur des versions du message qui ne sont pas encore définitives, la réponse peut donc différer d'un démarrage à froid. C'est pourquoi on la mesure sur des réponses vérifiables : 24/24 des deux côtés, sur la RTX 2060 et sur le M2 Pro.
Ce que vous obtenez
Pas de PyTorch, pas de téléchargements manuels. MAFDET examine votre machine, installe la bonne build de llama.cpp et choisit le modèle qui y tourne le mieux. Puis il se met au travail avant vous.
Le prefill est fait avant Entrée, à chaque pause. Exact, quoi que vous fassiez au texte : retours arrière, modifications, documents collés.
Avec Qwen3, le modèle raisonne par courts segments sur le message tel qu'il est, et garde ses notes quand vous le changez. Deux tiers du raisonnement faits avant Entrée sur le 4B.
La machine de référence est une RTX 2060 avec 6 Go. Apple Silicon tourne via Metal, AMD Radeon via Vulkan, et tout tourne aussi sur un CPU.
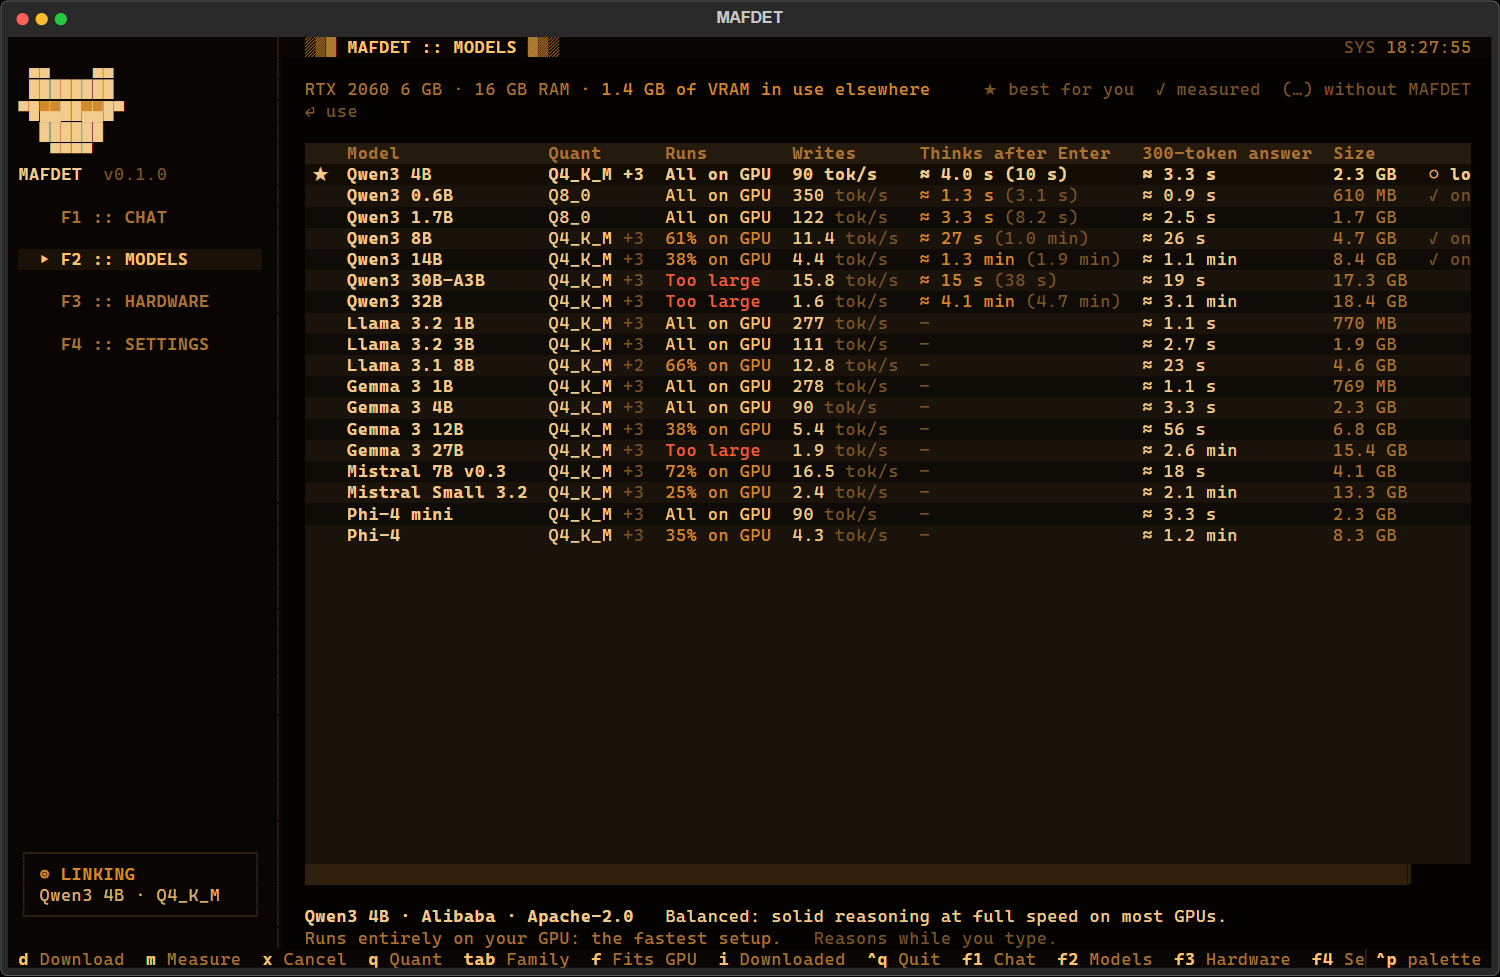
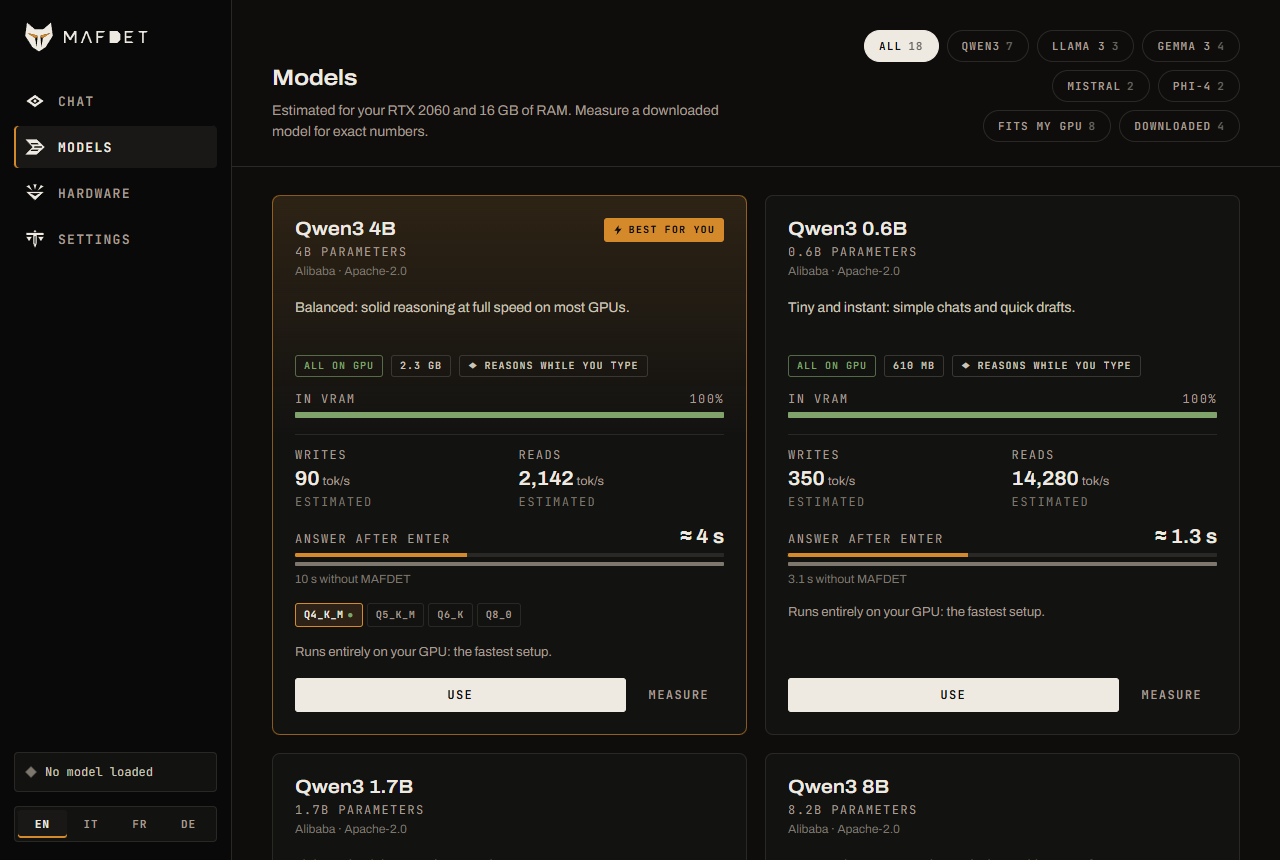
Chaque modèle dit, avant le téléchargement, s'il tient dans la VRAM, à quelle vitesse il lit et écrit, et l'attente après Entrée avec et sans MAFDET. Estimations à 12 % près des vitesses mesurées.
Cinq familles au catalogue : Qwen3, Llama 3, Gemma 3, Mistral et Phi-4. Au-delà, cherchez sur Hugging Face depuis l'appli ou ajoutez un fichier à vous.
Benchmarks, simulation de frappe et contrôles d'exactitude sont livrés avec l'appli. Mesurez un modèle en une demi-minute ; jugez le moteur contre un calcul à partir de zéro.
L'appli
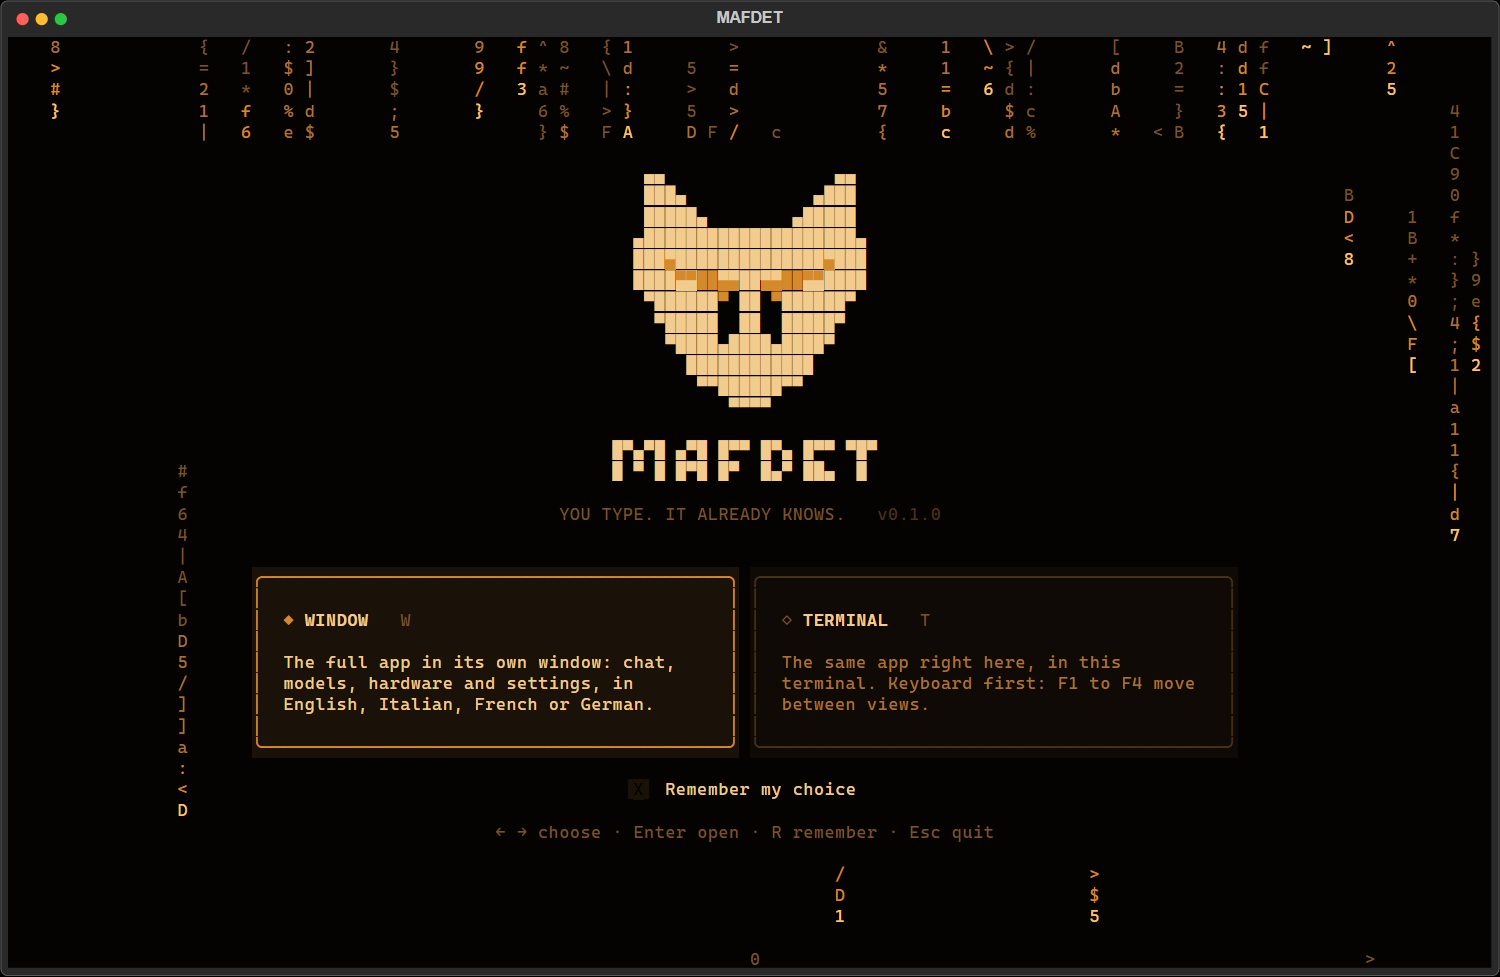
La fenêtre, en anglais, italien, français ou allemand. Ou l'appli terminal, clavier d'abord, sur un écran au phosphore ambré avec une séquence de démarrage. Mêmes vues, même moteur, mêmes chiffres sous chaque réponse.


La ligne de commande
Une seule CLI mafdet, dans l'esprit de la déesse dont elle porte le nom. L'appli et les scripts de recherche partagent le même moteur : ce que vous mesurez est ce que vous exécutez.
$ mafdet doctor
l'éveil
Vérifie le GPU, la mémoire, llama.cpp et les modèles. --install installe llama.cpp avec la bonne build.
$ mafdet watch
l'affût
La fenêtre de chat avec un modèle et des options depuis la ligne de commande ; lit à l'avance pendant que vous tapez.
$ mafdet strike
la frappe
Raisonnement anticipé pendant que vous tapez, conservé d'une modification à l'autre, et la réponse exacte écrite d'avance à une pause.
$ mafdet hunt
la chasse
Simule des gens qui tapent, proprement, salement ou en collant, et mesure l'attente après l'envoi.
$ mafdet race
la course
Benchmarks du prefill et du decode sur votre machine, sur llama.cpp ou sur PyTorch.
$ mafdet judge
le jugement
Vérifie les résultats contre un calcul à partir de zéro. Doit se terminer avec 0 erreur.
Commencer
Python 3.10 ou plus récent est tout ce qu'il faut. Le premier démarrage examine votre machine, installe llama.cpp et télécharge le modèle qui y tourne le mieux ; le terminal affiche chaque téléchargement avec sa taille, sa vitesse et le temps restant.
En double-cliquant
git clone).start_mafdet.bat. La première fois, il crée un environnement Python dans .venv et installe MAFDET, environ une minute. Il faut Python 3.10 ou plus récent.Depuis PyPI
Avec le Python de python.org, pip fonctionne tel quel.
$ pip install mafdet $ mafdet
Tourne sur NVIDIA via CUDA (référence : RTX 2060, 6 Go), sur AMD Radeon via Vulkan (en place, pas encore mesuré), ou sur le CPU.
En double-cliquant
git clone).start_mafdet.command. Python 3.10 ou plus récent : depuis python.org, ou brew install python@3.12.Depuis PyPI, avec pipx
Le Python de Homebrew refuse pip install hors d'un environnement virtuel : pipx donne à MAFDET un environnement à lui.
$ brew install pipx $ pipx ensurepath # puis ouvrez un nouveau terminal $ pipx install mafdet $ mafdet
Apple Silicon (M1 ou plus récent) fait tourner les modèles sur le GPU via Metal, dans la mémoire unifiée. Testé sur un M2 Pro avec 16 Go. Les Mac Intel tournent sur le CPU.
Pas encore testé
Linux a ses builds de llama.cpp et ses chemins de code en place (CUDA, Vulkan, CPU), mais personne n'y a encore fait tourner MAFDET de bout en bout. Si vous essayez, une issue avec la sortie de mafdet doctor est la chose la plus utile que vous puissiez envoyer.
Depuis PyPI, avec pipx
Les Ubuntu et Debian récents bloquent pip install avec externally-managed-environment : utilisez pipx.
$ sudo apt install pipx $ pipx ensurepath # puis ouvrez un nouveau terminal $ pipx install mafdet $ mafdet
Dans un terminal
Aussi pour les mesures dans research/.
$ git clone https://github.com/TheLastOxygen/mafdet.git $ cd mafdet $ python -m venv .venv # Windows: py -3.12 -m venv .venv $ source .venv/bin/activate # Windows: .venv\Scripts\Activate.ps1 $ pip install -e . $ mafdet
Mise à jour
$ pipx upgrade mafdet # ou : pip install -U mafdet
Les scripts à double-clic mettent à jour leur environnement eux-mêmes après un git pull.
Dans les deux cas : MAFDET demande s'il faut ouvrir la fenêtre ou l'appli terminal, examine votre machine, installe la bonne build de llama.cpp (CUDA, Vulkan, Metal ou CPU) et télécharge le modèle qui tourne le mieux. Pas de PyTorch, pas de téléchargements manuels.
Open source
Un prototype de Simone Di Mauro et Simone Di Natale, le journal de recherche au grand jour, chaque benchmark dans le dépôt avec le script qui l'a produit. Les étoiles, les issues et les mesures sur d'autres matériels sont ce qui le fait avancer. Qui ils sont →
Confidentialité
L'inférence tourne en local, sur llama.cpp. Les seuls téléchargements ont lieu à l'installation : llama.cpp depuis ses releases GitHub, et les modèles que vous choisissez depuis Hugging Face. Ensuite, rien ne sort.
Feuille de route
Aide recherchée
MAFDET tourne sur les cartes Radeon via la build Vulkan de llama.cpp, mais personne ne l'a encore mesuré sur l'une d'elles. Une demi-heure d'une RX 5000 ou plus récente comblerait ce manque : installez, lancez Mesurer sur Qwen3-4B, exécutez research/thinking_ahead.py, ouvrez une issue.
Questions
La lecture anticipée est exacte : le cache KV finit identique à celui d'un calcul à partir de zéro, quoi que vous ayez fait au texte, et mafdet judge le vérifie. Le raisonnement anticipé ne l'est pas, parce que le modèle raisonne sur des versions du message qui ne sont pas définitives ; c'est pourquoi on le mesure sur des problèmes à réponse connue. Sur Qwen3-4B : 24/24 avec et sans, sur les deux machines.
Qwen3 en mode thinking, la seule famille dont le cadre de raisonnement a été mesuré. Tout autre modèle du catalogue, et tout GGUF que vous ajoutez, est lu pendant que vous tapez et, à une pause, a sa réponse écrite d'avance ; cette partie est exacte et vaut pour le texte exact pour lequel elle a été écrite.
Non. L'inférence tourne en local sur llama.cpp. Les seuls téléchargements ont lieu à l'installation : llama.cpp depuis ses releases GitHub et les modèles depuis Hugging Face. Les modèles à accès restreint (Llama, Gemma) demandent d'accepter leur licence sur huggingface.co.
La machine de référence est une RTX 2060 avec 6 Go de VRAM. Les Mac Apple Silicon font tourner les modèles sur le GPU via Metal (testé : M2 Pro, 16 Go). Les cartes AMD Radeon tournent via Vulkan, pas encore mesuré. Tout tourne aussi sur un CPU ; 16 Go de RAM y sont recommandés, ainsi que pour les modèles plus gros que la VRAM.
Environ 0,7 Go pour llama.cpp avec CUDA (100 Mo avec Vulkan, 60 Mo pour le CPU), plus les modèles : de 0,6 Go pour Qwen3-0.6B à 2,3 Go pour le 4B recommandé sur les cartes de 6-8 Go. Pas de PyTorch.
D'après Mafdet, la déesse féline de l'Égypte ancienne dite « la coureuse », qui frappait serpents et scorpions avant qu'ils ne puissent attaquer. Les six commandes sont ses verbes : éveiller, guetter, frapper, chasser, courir, juger.
C'est un prototype, et il le dit : Windows et macOS sont testés, Linux pas encore, Radeon n'est pas mesuré. Le moteur est vérifié et les résultats sont reproductibles ; les finitions sont encore en cours. Les issues sont les bienvenues.
Plus dans le README, qui est le manuel complet.
Les autres modèles attendent que vous ayez fini d'écrire. MAFDET commence avant.
pipx install mafdet