Qwen3-4B
RTX 2060 · 6 GB · 24 problemas
3.8×más rápido
Sin razonamiento anticipado12.2 s
◆ Con MAFDET3.2 s
24/24 con y sin. Cabe en la VRAM, 83 tok/s. Más rápido en 24 de 24 problemas. Razonamiento pendiente tras Enter: 944 → 244 tokens.
IA local · lee y piensa mientras escribes
Las apps de chat dejan la GPU sin hacer nada mientras escribes. MAFDET aprovecha ese tiempo: lee tu mensaje mientras lo tecleas y empieza a razonar antes de que pulses Enter. Con Qwen3-4B la espera tras Enter pasa de 12.2 s a 3.2 s, con las mismas respuestas. Todo en local, sobre llama.cpp.
pipx install mafdetWindows · macOS en Apple Silicon · Linux sin probar · NVIDIA CUDA, AMD Vulkan, Apple Metal o CPU
¿Todo esto te suena nuevo? Lee la versión en palabras sencillas →
Inactivo mientras escribes. Tras Enter: lee el mensaje y luego razona desde cero.
Una simulación ilustrativa en tu navegador: aquí no se ejecuta ningún modelo. Tiempos a escala del benchmark de Qwen3-4B en una RTX 2060 (24 problemas de enunciado tecleados en tiempo real, espera media tras Enter 12.2 s → 3.2 s). Reproducción a 3× de velocidad.
Medido, no prometido
Problemas de enunciado con respuesta numérica conocida, tecleados en tiempo real a 5-8 caracteres por segundo, Enter justo después del último carácter. La espera es hasta la primera palabra de la respuesta. Cada ejecución está en el repositorio.
RTX 2060 · 6 GB · 24 problemas
3.8×más rápido
24/24 con y sin. Cabe en la VRAM, 83 tok/s. Más rápido en 24 de 24 problemas. Razonamiento pendiente tras Enter: 944 → 244 tokens.
RTX 2060 · 6 GB · 6 problemas
2.3×más rápido
6/6 con y sin. Más grande que la VRAM: 38% en la GPU, unos 5 tok/s. Seis problemas dan el orden de magnitud, no una cifra precisa.
MacBook Pro M2 Pro · 16 GB · 24 problemas
3.2×más rápido
24/24 con y sin. Metal, 54 tok/s. Más rápido en 24 de 24 problemas. Razonamiento pendiente tras Enter: 966 → 248 tokens.
MacBook Pro M2 Pro · 16 GB · 6 problemas
2.7×más rápido
6/6 con y sin. El 14B entero cabe en la memoria unificada y escribe a 18 tok/s.
Condiciones
Qwen3 Q4_K_M en modo thinking sobre llama.cpp. Espera media tras Enter; la RTX 2060 tiene 6 GB de VRAM, el Mac 16 GB de memoria unificada. Dos ejecuciones de los mismos 24 problemas difieren hasta en un segundo: son órdenes de magnitud, con los datos y los scripts para repetirlos.
Lee la investigación →Cómo funciona
Un LLM lee un prompt en una fase rápida y paralela (prefill) y luego escribe un token cada vez (decode). Un modelo de razonamiento piensa durante cientos de tokens antes de su primera palabra. MAFDET adelanta las dos cosas a antes de Enter.
En cada pausa MAFDET tokeniza el texto, mantiene la caché KV sincronizada con él y retiene los últimos tokens: una palabra que aún estás escribiendo puede cambiar cómo se divide el texto.
El prefill se hace mientras escribes. Con Qwen3 el modelo además razona en fragmentos cortos sobre el mensaje tal como está. Cuando editas, ese razonamiento se queda en el prompt como notas y el modelo continúa desde ahí.
Solo se leen los últimos tokens, el modelo termina de razonar desde donde iba y responde. Con Qwen3-4B, unos dos tercios del razonamiento están hechos antes de Enter.
La caché KV, sincronizada con tu texto
Retrocesos, ediciones en medio, bloques pegados: la comprobación del prefijo común recorta la caché a lo que sigue valiendo y hace el prefill solo de lo nuevo. La lectura anticipada es exacta; el resultado es el que daría un cálculo desde cero.
Lectura anticipada · exacta
Las heurísticas como la retención y el debounce solo afectan a cuánto trabajo se desperdicia, nunca al resultado. Comprobado por mafdet judge contra un cálculo desde cero: 0 errores.
Razonamiento anticipado · medido
El modelo razona sobre versiones del mensaje que aún no son definitivas, así que la respuesta puede diferir de la de un arranque en frío. Por eso se mide con respuestas que se pueden comprobar: 24/24 en los dos lados, en la RTX 2060 y en el M2 Pro.
Lo que obtienes
Sin PyTorch, sin descargas manuales. MAFDET mira tu máquina, instala la build adecuada de llama.cpp y elige el modelo que mejor funciona en ella. Luego se pone a trabajar antes que tú.
El prefill se hace antes de Enter, en cada pausa. Exacto, hagas lo que hagas con el texto: retrocesos, ediciones, documentos pegados.
Con Qwen3 el modelo razona en fragmentos cortos sobre el mensaje tal como está, y conserva sus notas cuando lo cambias. Dos tercios del razonamiento hechos antes de Enter en el 4B.
La máquina de referencia es una RTX 2060 con 6 GB. Apple Silicon funciona con Metal, AMD Radeon con Vulkan, y todo funciona también en una CPU.
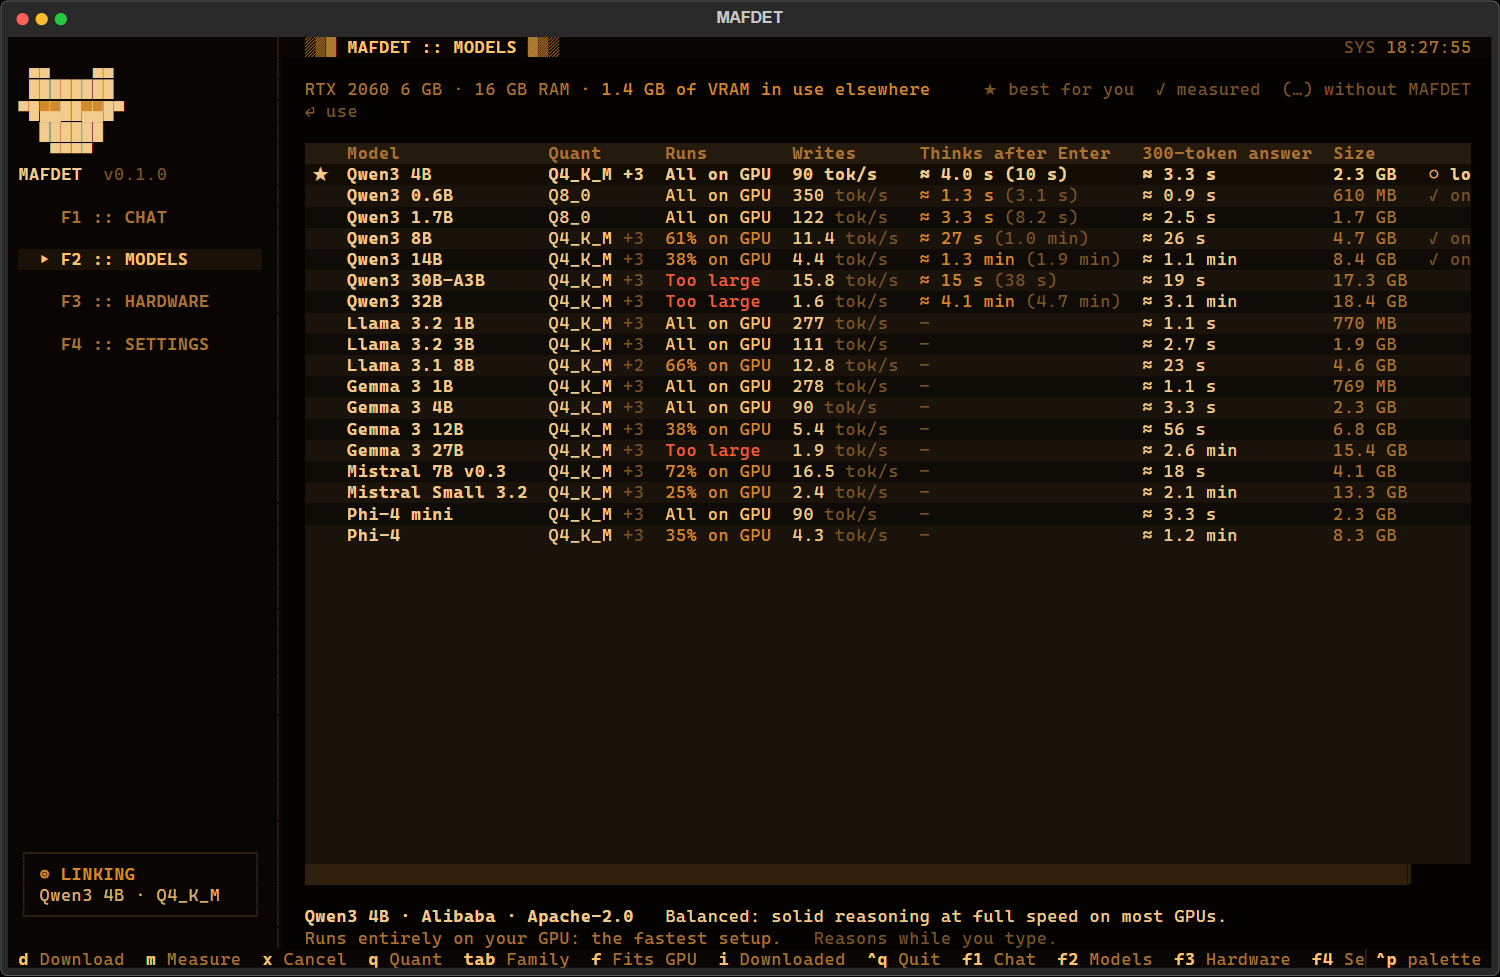
Cada modelo dice, antes de descargarlo, si cabe en la VRAM, a qué velocidad lee y escribe, y la espera tras Enter con y sin MAFDET. Estimaciones con un margen del 12% respecto a las velocidades medidas.
Cinco familias en el catálogo: Qwen3, Llama 3, Gemma 3, Mistral y Phi-4. Fuera de él, busca en Hugging Face desde la app o añade un archivo propio.
Benchmarks, simulación de escritura y comprobaciones de corrección vienen con la app. Mide un modelo en medio minuto; juzga el motor contra un cálculo desde cero.
La app
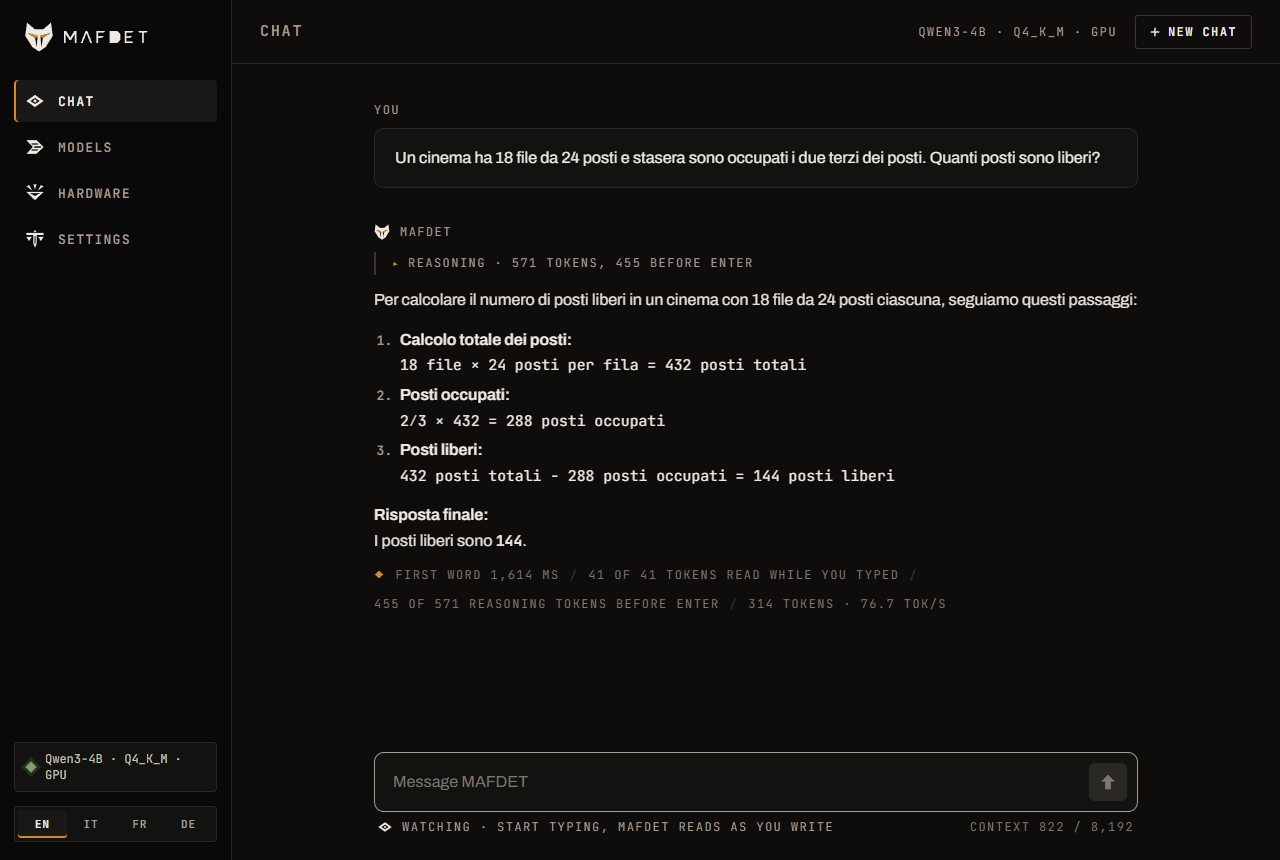
La ventana, en inglés, italiano, francés o alemán. O la app de terminal, pensada para el teclado, en una pantalla de fósforo ámbar con secuencia de arranque. Las mismas vistas, el mismo motor, los mismos números bajo cada respuesta.
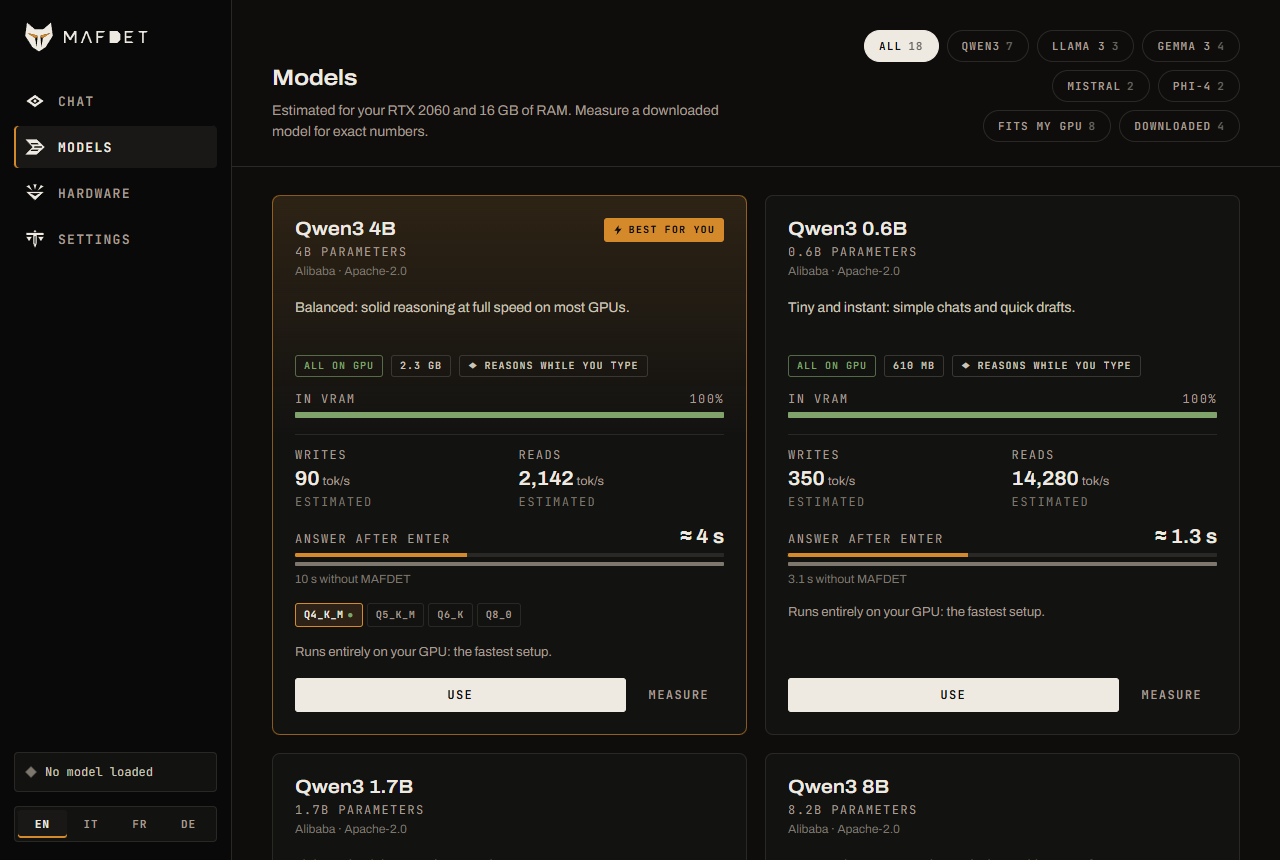
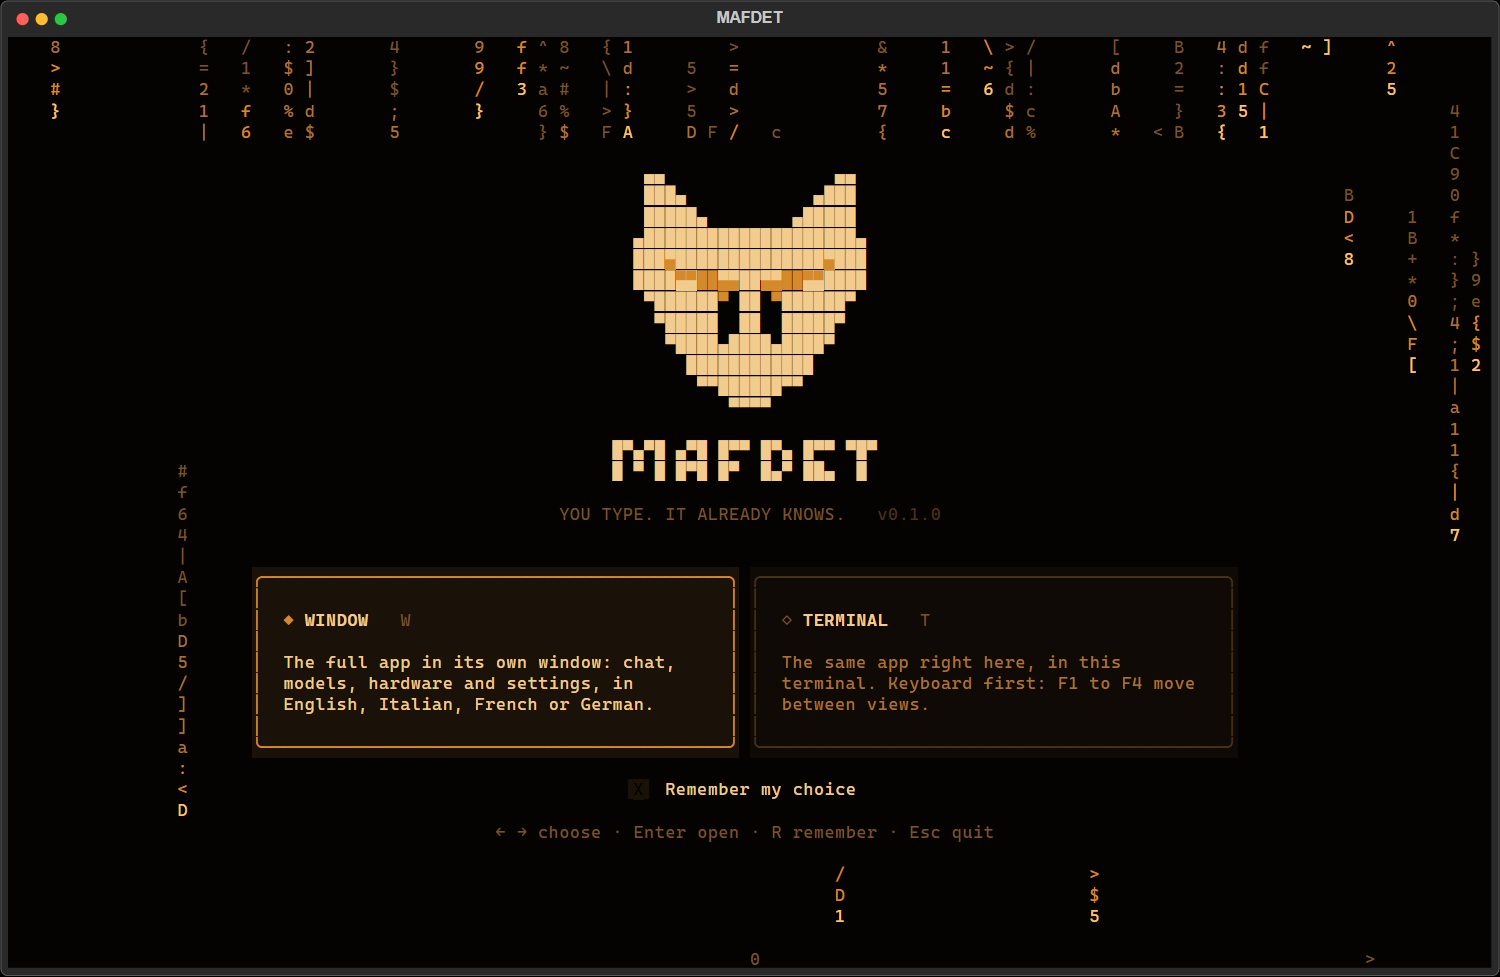
La línea de comandos
Una sola CLI mafdet, en el espíritu de la diosa de la que toma el nombre. La app y los scripts de investigación comparten el mismo motor, así que lo que mides es lo que ejecutas.
$ mafdet doctor
el despertar
Comprueba la GPU, la memoria, llama.cpp y los modelos. --install instala llama.cpp con la build adecuada.
$ mafdet watch
el acecho
La ventana de chat con un modelo y opciones desde la línea de comandos; lee por adelantado mientras escribes.
$ mafdet strike
el golpe
Razonamiento anticipado mientras escribes, conservado entre ediciones, y la respuesta exacta por adelantado en una pausa.
$ mafdet hunt
la caza
Simula a personas escribiendo, limpio, desordenado o pegando, y mide la espera tras el envío.
$ mafdet race
la carrera
Mide prefill y decode en tu máquina, sobre llama.cpp o sobre PyTorch.
$ mafdet judge
el juicio
Comprueba los resultados contra un cálculo desde cero. Debe terminar con 0 errores.
Empezar
Solo necesitas Python 3.10 o posterior. El primer arranque mira tu máquina, instala llama.cpp y descarga el modelo que mejor funciona en ella; la terminal muestra cada descarga con su tamaño, velocidad y tiempo restante.
Con doble clic
git clone).start_mafdet.bat. La primera vez crea un entorno de Python en .venv e instala MAFDET, alrededor de un minuto. Necesita Python 3.10 o posterior.Desde PyPI
Con el Python de python.org, pip funciona tal cual.
$ pip install mafdet
$ mafdet
Funciona en NVIDIA con CUDA (referencia: RTX 2060, 6 GB), en AMD Radeon con Vulkan (implementado, aún sin medir) o en la CPU.
Con doble clic
git clone).start_mafdet.command. Python 3.10 o posterior: desde python.org, o brew install python@3.12.Desde PyPI, con pipx
El Python de Homebrew rechaza pip install fuera de un entorno virtual: pipx le da a MAFDET un entorno propio.
$ brew install pipx
$ pipx ensurepath        # luego abre una terminal nueva
$ pipx install mafdet
$ mafdet
Apple Silicon (M1 o posterior) ejecuta los modelos en la GPU con Metal, en la memoria unificada. Probado en un M2 Pro con 16 GB. Los Mac con Intel funcionan en la CPU.
Aún sin probar
Linux tiene sus builds de llama.cpp y sus rutas de código listas (CUDA, Vulkan, CPU), pero nadie ha ejecutado MAFDET en él de principio a fin todavía. Si lo pruebas, un issue con la salida de mafdet doctor es lo más útil que puedes enviar.
Desde PyPI, con pipx
Las versiones recientes de Ubuntu y Debian detienen pip install con externally-managed-environment: usa pipx.
$ sudo apt install pipx
$ pipx ensurepath        # luego abre una terminal nueva
$ pipx install mafdet
$ mafdet
En una terminal
También para las mediciones de research/.
$ git clone https://github.com/TheLastOxygen/mafdet.git
$ cd mafdet
$ python -m venv .venv          # Windows: py -3.12 -m venv .venv
$ source .venv/bin/activate     # Windows: .venv\Scripts\Activate.ps1
$ pip install -e .
$ mafdet
Actualizar
$ pipx upgrade mafdet # o: pip install -U mafdet
Los scripts de doble clic actualizan su entorno por sí solos tras un git pull.
En cualquier caso: MAFDET pregunta si abrir la ventana o la app de terminal, mira tu máquina, instala la build adecuada de llama.cpp (CUDA, Vulkan, Metal o CPU) y descarga el modelo que mejor funciona. Sin PyTorch, sin descargas manuales.
Código abierto
Un prototipo de Simone Di Mauro y Simone Di Natale, el diario de investigación a la vista, cada benchmark en el repositorio con el script que lo produjo. Estrellas, issues y mediciones en otro hardware son lo que lo hace avanzar. Quiénes son →
Privacidad
La inferencia corre en local, sobre llama.cpp. Las únicas descargas son en la instalación: llama.cpp desde sus releases de GitHub, y los modelos que elijas desde Hugging Face. Después, nada sale.
Hoja de ruta
Se busca ayuda
MAFDET funciona en tarjetas Radeon con la build Vulkan de llama.cpp, pero nadie lo ha medido en una todavía. Media hora de una RX 5000 o posterior llenaría ese hueco: instala, Mide Qwen3-4B, ejecuta research/thinking_ahead.py, abre un issue.
Preguntas
La lectura anticipada es exacta: la caché KV acaba idéntica a la de un cálculo desde cero, hagas lo que hagas con el texto, y mafdet judge lo comprueba. El razonamiento anticipado no lo es, porque el modelo razona sobre versiones del mensaje que no son definitivas; por eso se mide con problemas de enunciado de respuesta conocida. Con Qwen3-4B: 24/24 con y sin, en las dos máquinas.
Qwen3 en modo thinking, la única familia cuyo marco de razonamiento se ha medido. Cualquier otro modelo del catálogo, y cualquier GGUF que añadas, se lee mientras escribes y, en una pausa, tiene su respuesta escrita por adelantado; esa parte es exacta y vale para el texto exacto para el que se escribió.
No. La inferencia corre en local sobre llama.cpp. Las únicas descargas son en la instalación: llama.cpp desde sus releases de GitHub y los modelos desde Hugging Face. Los modelos con acceso restringido (Llama, Gemma) requieren aceptar su licencia en huggingface.co.
La máquina de referencia es una RTX 2060 con 6 GB de VRAM. Los Mac con Apple Silicon ejecutan los modelos en la GPU con Metal (probado: M2 Pro, 16 GB). Las tarjetas AMD Radeon funcionan con Vulkan, aún sin medir. Todo funciona también en una CPU; ahí se recomiendan 16 GB de RAM, igual que para modelos más grandes que la VRAM.
Unos 0.7 GB para llama.cpp con CUDA (100 MB con Vulkan, 60 MB para la CPU), más los modelos: desde 0.6 GB para Qwen3-0.6B hasta 2.3 GB para el 4B recomendado en tarjetas de 6-8 GB. Sin PyTorch.
Por Mafdet, la diosa felina del antiguo Egipto conocida como "la corredora", que golpeaba a serpientes y escorpiones antes de que pudieran atacar. Los seis comandos son sus verbos: despertar, acechar, golpear, cazar, correr, juzgar.
Es un prototipo, y lo dice sin rodeos: Windows y macOS están probados, Linux aún no, Radeon no está medida. El motor está comprobado y los resultados son reproducibles; los bordes aún se están puliendo. Los issues son bienvenidos.
Más en el README, que es el manual completo.
Otros modelos esperan a que termines de escribir. MAFDET empieza antes.
pipx install mafdet